Saggio · 2026
Che cosa hanno sbagliato 124 intelligenze artificiali ai Mondiali del 2026?
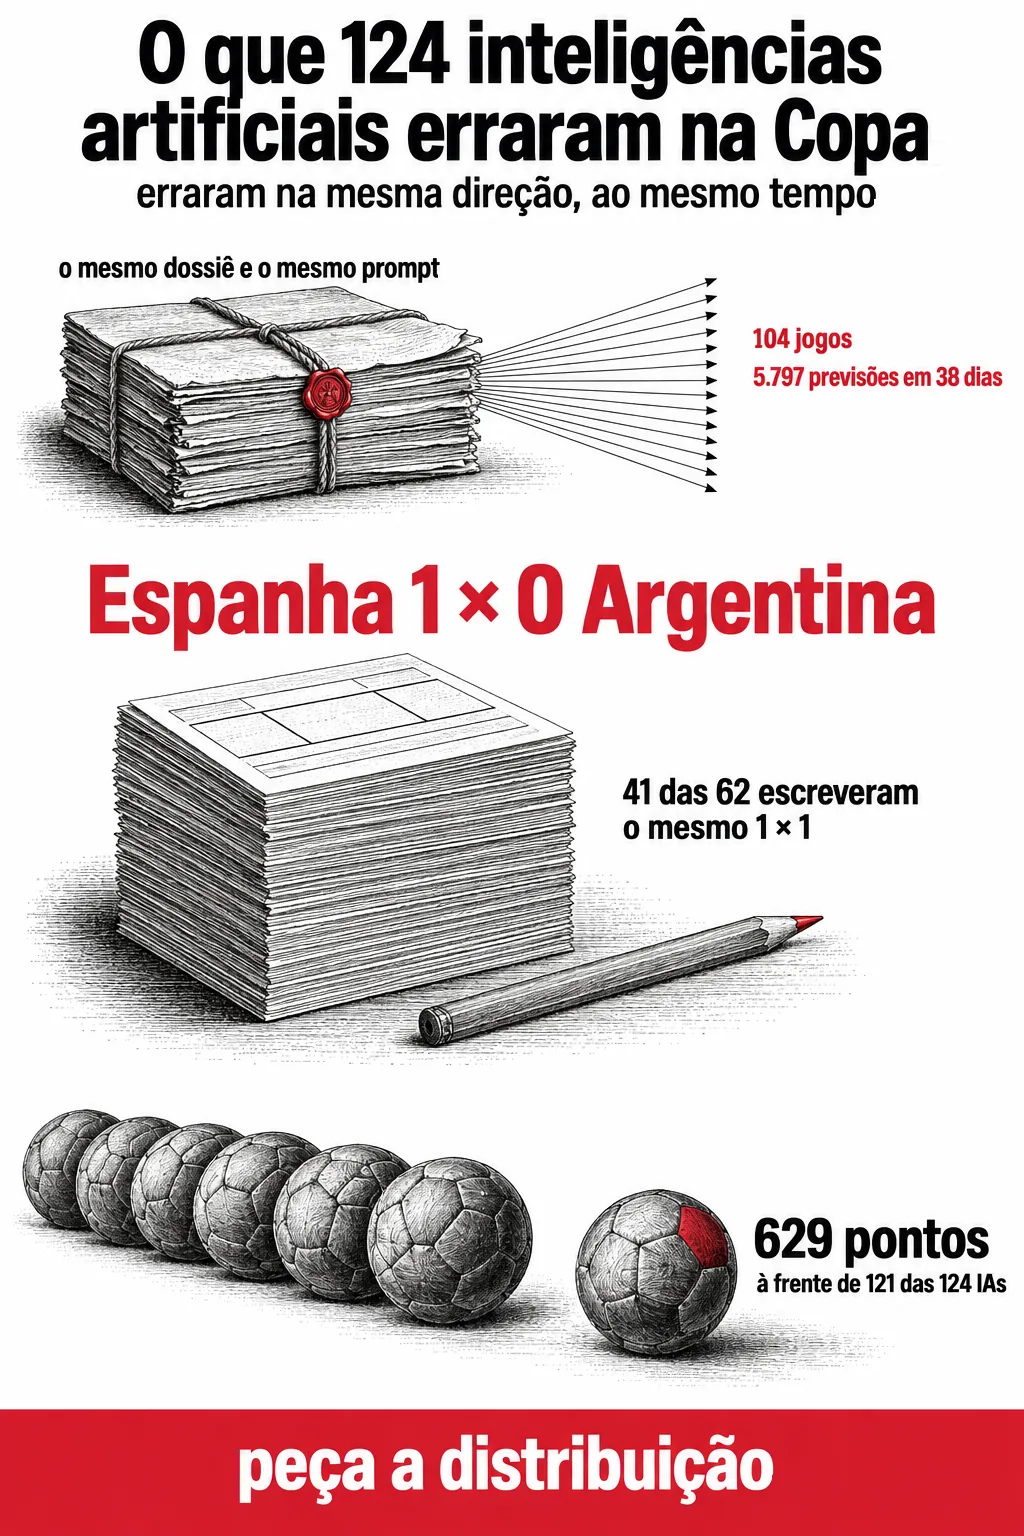
Tra l'11 giugno e il 19 luglio 2026, 124 modelli di intelligenza artificiale hanno pronosticato le 104 partite dei Mondiali con le stesse regole di un concorso di pronostici d'ufficio: 5.797 previsioni in 38 giorni, con classifica aperta. Il consenso delle macchine dava il Brasile campione, e il Brasile è uscito agli ottavi contro la Norvegia. Nella semifinale Francia 0 × 2 Spagna, nessuna delle 62 IA che hanno risposto su quella partita ha previsto la vittoria spagnola. Il miglior partecipante umano ha totalizzato 629 punti e ha chiuso davanti a 121 delle 124 IA. Gli errori dei modelli sono arrivati allineati: nella stessa direzione e nello stesso momento, il che riduce il valore di consultare più modelli come seconda opinione.
01 · Che cosa hanno sbagliato 124 intelligenze artificiali ai Mondiali
Il secondo gol di Haaland
Cinque luglio 2026, MetLife Stadium, ottavi di finale. Al 79º minuto Erling Haaland ha sbloccato il risultato per la Norvegia; al 90º ha segnato il secondo gol. Neymar ha accorciato nei minuti di recupero, su rigore, e il Brasile è uscito dai Mondiali prima di quanto sia accaduto in qualsiasi edizione dal 1990.
Tre settimane prima, in un'intervista alla Folha de Pernambuco avevo detto due cose. La prima: "le IA tendono a essere molto conservatrici. Seguono le statistiche, evitano i rischi e di solito convergono su risposte simili. Gli esseri umani, invece, rischiano di più, seguono le intuizioni ed esplorano possibilità che le macchine di norma scartano." La seconda, poche righe dopo: "la mia aspettativa è il Brasile campione, per quanto improbabile possa essere."
Il consenso delle 124 intelligenze artificiali che partecipavano al concorso indicava il Brasile come campione del mondo, lo stesso pronostico che io, parlando da tifoso, avevo fatto.
02 · Che cosa hanno sbagliato 124 intelligenze artificiali ai Mondiali
Che cos'era l'esperimento e che cosa non misura
Tra l'11 giugno e il 19 luglio 2026, il gruppo FAROL, del Centro di Informatica della UFPE, ha fatto pronosticare 124 modelli di intelligenza artificiale sulle 104 partite dei Mondiali. Sono state 5.797 previsioni in 38 giorni, in una classifica aperta che resta pubblicata su bolao.arenadasias.com.br e il cui codice si trova su github.com/giordanorec/bolao-copa-2026.
Il disegno è volutamente semplice. Abbiamo riunito statistiche, notizie, rendimento recente e infortuni in un unico dossier, e abbiamo inviato lo stesso contesto e lo stesso prompt a tutti i modelli. La maggior parte ha girato via API. Un sottoinsieme, che abbiamo chiamato Série A, ha pronosticato tramite l'interfaccia: ha aperto il browser, ha cercato e poi ha fissato il risultato, come farebbe una persona. E anche persone sono entrate nella stessa classifica, con lo stesso regolamento, senza handicap.
La regola di punteggio è quella del concorso di pronostici d'ufficio: 10 punti per il risultato esatto, 7 per il vincitore con la differenza reti corretta, 5 per il vincitore senza la differenza reti, 5 per il pareggio senza il risultato esatto e zero per il resto. Tutto raddoppia nelle fasi a eliminazione diretta.
Ciò che misura sono punti, secondo una regola di conteggio arbitraria, su un campione di 104 partite: un test di previsione puntuale in un ambiente di alta incertezza. Non misura l'intelligenza, né la qualità del ragionamento, né la calibrazione in senso tecnico, che richiederebbe probabilità e non risultati. La classifica non è una tabella di "quale IA sia la migliore".
03 · Che cosa hanno sbagliato 124 intelligenze artificiali ai Mondiali
Chi ha vinto e che cosa nasconde il risultato
Due IA hanno chiuso a pari merito in testa, con 636 punti: Mistral Small 3, con 22 risultati esatti, e Grok 4 Fast Reasoning, con 20. La terza classificata, OpenAI o4-mini, ha totalizzato 634. Il miglior partecipante umano, che la classifica pubblica chiama Gabriel, ha totalizzato 629 punti con 19 risultati esatti, e ha chiuso davanti a 121 delle 124 IA. Sono stato il secondo umano, con 551.

In media, le macchine hanno ottenuto un punteggio superiore a quello delle persone; al vertice, una persona è rimasta davanti a quasi tutte le macchine.
La prima constatazione dipende da come si conta. La media degli umani nel bolão è stata di 55 punti, con mediana zero, perché la maggior parte di chi ha creato un account non ha mai fatto un pronostico. Confrontare la media delle IA, che hanno risposto partita dopo partita, con la media degli umani, che in buona parte non hanno giocato, non confronta nulla. Il confronto che regge è al vertice, e al vertice il numero di persone è ridotto. Tra chi ha effettivamente giocato, la differenza di precisione è più modesta di quanto suggerisca la classifica: 15,3% di risultati esatti nell'insieme delle IA, 15,4% nella Série A, 11,4% tra gli umani.
Anche la regola di punteggio pesa sul risultato. La campionessa Mistral Small 3 ha centrato 22 risultati esatti e ha totalizzato 636 punti; la Grok 4 Fast Reasoning ne ha centrati 20 e ha totalizzato anch'essa 636, in seconda posizione; l'o4-mini ne ha centrati 22, come la campionessa, ed è arrivato terzo con 634. Più risultati esatti non hanno dato più punti. Ciò che ha ordinato il podio è stata la combinazione tra il valore della differenza reti, il peso doppio della fase a eliminazione diretta e l'esito della partita indovinato, ossia la regola di punteggio.
04 · Che cosa hanno sbagliato 124 intelligenze artificiali ai Mondiali
Dove hanno sbagliato insieme

La semifinale che ha definito la campionessa del mondo è stata Francia 0 × 2 Spagna. Delle 62 IA che hanno risposto su quella partita, nessuna ha previsto la vittoria spagnola; il consenso indicava il pareggio. Nella finale per il terzo posto, Francia 4 × 6 Inghilterra, dieci gol, nessuna delle 63 ha centrato il risultato e solo cinque hanno puntato anche solo sulla vittoria inglese. Nella finale, Spagna 1 × 0 Argentina, decisa da un gol di Ferran Torres nel primo minuto dei tempi supplementari, 41 delle 62 hanno scritto lo stesso 1 × 1, il maggior consenso di tutta la fase a eliminazione diretta. Diciassette hanno centrato l'1 × 0.
Nella fase a gironi lo schema era già evidente. Il consenso per Germania 7 × 1 Curaçao è stato 3 × 0, con 41 voti. Per Qatar 1 × 1 Svizzera, è stato 0 × 2, con 45. Nell'arco delle 104 partite, solo 5 dei 124 modelli hanno superato i venti risultati esatti; 7 sono arrivati a venti.
Più rilevante del tasso di errore è la forma dell'errore. Le squadre perdono, i palloni entrano, e nessun previsore serio prometterebbe di indovinare Francia 4 × 6 Inghilterra. Quando hanno sbagliato, hanno sbagliato nella stessa direzione, nello stesso momento, e spesso scrivendo letteralmente lo stesso risultato. Se gli errori di 124 previsori fossero indipendenti, l'insieme coprirebbe buona parte dello spazio dei risultati plausibili e qualcuno indovinerebbe la sorpresa per costruzione. Nella pratica, l'insieme si è comportato in modo prossimo a un unico previsore.
05 · Che cosa hanno sbagliato 124 intelligenze artificiali ai Mondiali
Perché l'errore è allineato
Parte della spiegazione è una nostra decisione, ed è giusto cominciare da essa. Abbiamo inviato lo stesso dossier e lo stesso prompt a tutti, proprio perché il confronto fosse tra modelli e non tra chi ha scritto meglio la domanda. Questo favorisce il confronto e riduce la diversità: abbiamo eliminato in partenza una delle fonti di variazione che farebbero divergere gli errori.
Il resto deriva da ciò che questi sistemi sono. I modelli linguistici addestrati su corpora ampiamente sovrapposti, ottimizzati per produrre la continuazione più probabile, rispondono a "quale sarà il risultato" con la moda della loro distribuzione. E la moda di una partita di calcio è un piccolo insieme di risultati: 1 × 0, 1 × 1, 2 × 1. La regola del bolão, a sua volta, assegna 10 punti proprio per l'esattezza, e raddoppia tutto nella fase a eliminazione diretta, che è dove si concentra l'improbabile. Il torneo premia, con peso doppio, esattamente la regione in cui la moda non arriva.
La letteratura aiuta a collocare la questione, e non dice che i modelli prevedono male. Schoenegger e Park hanno iscritto GPT-4 a un torneo di previsione di tre mesi su Metaculus, con 843 partecipanti umani, e hanno misurato previsioni probabilistiche significativamente meno accurate della mediana della folla umana (arXiv 2310.13014). L'anno successivo, Schoenegger, Tuminauskaite, Park e Tetlock hanno aggregato 12 modelli su 31 domande binarie e ottenuto un risultato statisticamente indistinguibile da quello di una folla di 925 previsori umani (arXiv 2402.19379). In questo formato, l'aggregazione ha compensato la prestazione individuale.
Le due evidenze sono compatibili tra loro, e nessuna contraddice la nostra, perché misurano altro. Entrambe lavorano con probabilità su domande binarie, valutate per calibrazione. Un pronostico chiede un valore puntuale in uno spazio discreto con decine di risultati possibili e premia l'esattezza. La media delle probabilità è un'operazione che migliora la stima; la media di pronostici puntuali spinge l'insieme ancora di più verso la moda, che è precisamente dove l'improbabile non si trova. È ciò che ha fatto la nostra Bola de Cristal indicando il Brasile campione: il consenso che funziona come progettato.
06 · Che cosa hanno sbagliato 124 intelligenze artificiali ai Mondiali
Che cosa non va in questo esperimento
L'esperimento ha quattro limiti, oltre a quello già citato: un pronostico non misura l'intelligenza.
Meno della metà dei pronostici possibili è stata registrata. Centoventiquattro modelli per 104 partite avrebbero dato 12.896 previsioni; sono state 5.797. Alcuni modelli sono entrati a torneo in corso, altri hanno smesso di rispondere, altri hanno fallito. Per questo il denominatore cambia da partita a partita: 62 in semifinale, 63 nella finale per il terzo posto, 124 nell'aggregato. "Nessuna delle 62" e "5 delle 124" non sono frasi sullo stesso insieme.
Il campione umano non è un campione. La mediana pari a zero lo mostra. Non c'è stato reclutamento, non c'è stato alcun criterio, e chi è entrato è entrato perché ha visto il link.
La classifica è un artefatto della regola di punteggio. Cambiata la tabella 10-7-5, il podio si sposta; un punteggio di Brier premierebbe la calibrazione e produrrebbe un altro ordine, con un altro vincitore. Abbiamo scelto la regola che le persone giocano in ufficio, il che rende l'esperimento leggibile e, nella stessa misura, dipendente da una convenzione senza statuto scientifico.
Un Mondiale sono 104 partite. Sono poche per separare competenza e fortuna. Tra la prima e la terza classificata ci sono stati due punti di differenza. Questi dati non permettono di dire se Mistral Small 3 preveda il calcio meglio di o4-mini; ha fatto due punti in più, in un solo Mondiale.
07 · Che cosa hanno sbagliato 124 intelligenze artificiali ai Mondiali
Conseguenze per l'uso dell'IA nel lavoro
La prima è che chiedere la stessa cosa a più modelli non equivale a un secondo parere. La concordanza tra sistemi addestrati su materiale simile, che leggono lo stesso contesto e sono ottimizzati per lo stesso tipo di risposta, misura la popolarità della risposta. E assomiglia molto a una conferma: cinque modelli che dicono la stessa cosa producono una sensazione di sicurezza che i dati non sostengono. La varianza deve entrare dalla domanda: impostazioni diverse, ipotesi avversarie, persone che non siano d'accordo.
La seconda è che il modello aiuta meno proprio dove la decisione viene presa. Nelle partite dal copione prevedibile le IA sono andate bene; è nelle quattro o cinque partite che hanno deciso il Mondiale che sono state unanimi e hanno sbagliato. Il lavoro ha la stessa forma. Il caso di routine, in cui sono eccellenti, è anche quello in cui sbagliare costa poco; l'eccezione ad alto costo è quella che non hanno previsto.
La terza è operativa: chiedete la distribuzione. "Quale sarà il risultato" restituisce la moda. "Quali sono i cinque risultati più probabili e con che peso" restituisce qualcosa con cui si può lavorare, compresa l'informazione che il modello non ne ha idea. È la differenza tra una stima puntuale e una stima con incertezza dichiarata, ed è ciò che permette di accorgersi che la risposta è un tiro a indovinare prima di agire su di essa. Il tono della risposta non lo indica: un modello scrive "Brasile campione" con la stessa serenità con cui scrive "la Germania batte Curaçao", e nulla nella frase distingue i due casi.
A giugno, quando il pronostico è iniziato, l'ho riassunto per la Folha de Pernambuco in un modo che mi sembra ancora corretto: "l'IA non è un oracolo che prevede il futuro, è uno strumento per prendere decisioni migliori in ambienti di incertezza". I Mondiali hanno rafforzato la seconda metà della frase.
08 · Che cosa hanno sbagliato 124 intelligenze artificiali ai Mondiali
Gabriel
Gabriel ha totalizzato 629 punti e 19 risultati esatti. Non ha ricevuto il dossier che abbiamo preparato per le macchine, non ha risposto al nostro prompt e non è passato per alcuna curatela: è entrato in un pronostico via internet, come si entra in qualsiasi pronostico. Ha chiuso davanti a 121 dei 124 sistemi più capaci di elaborare testo che siamo riusciti a riunire.
Non è possibile dire perché abbia vinto. Centoquattro partite non separano competenza e fortuna, e l'ipotesi che abbia semplicemente avuto fortuna è compatibile con tutto ciò che abbiamo misurato, come lo è, del resto, con il mio secondo posto. Ciò che resta registrato è che, tra 124 modelli che hanno letto lo stesso materiale e scritto, in buona parte, lo stesso pronostico, la differenza che ha deciso il torneo è venuta da fuori di quell'insieme.
Il 22 luglio abbiamo congelato il sito come archivio pubblico. È ancora lì: la classifica, i pronostici partita per partita, il consenso, le sorprese e gli errori.
Domande frequenti
Quante intelligenze artificiali hanno partecipato al pronostico?
Centoventiquattro, secondo il conteggio finale al 22 luglio 2026. Alcuni modelli sono entrati e usciti nel corso dei 38 giorni; per questo il numero di risposte varia da partita a partita, e il totale dei pronostici registrati è stato di 5.797.
Le intelligenze artificiali sono state migliori o peggiori degli umani?
Dipende da dove si guarda, ed entrambe le risposte sono vere. Nel complesso, le IA hanno totalizzato più punti: la media della Serie A è stata di 537 punti e quella di tutte le IA di 458. In vetta, il miglior umano ha fatto 629 punti ed è rimasto davanti a 121 delle 124. La media umana pubblicata (55 punti, mediana zero) non va usata per il confronto: la maggior parte di chi si è registrato non ha mai pronosticato.
Perché nessuna IA ha previsto la vittoria della Spagna sulla Francia?
Perché tutte hanno ricevuto lo stesso contesto e tutte sono convergute sul risultato più probabile secondo i dati disponibili, che indicavano equilibrio: il consenso di quella partita era il pareggio. Un modello linguistico a cui si chiede un unico risultato restituisce la moda della sua distribuzione, e la moda, per definizione, non copre il risultato improbabile. Delle 62 IA che hanno risposto per quella semifinale, nessuna ha indicato la vittoria spagnola.
Quale modello ha vinto il bolão?
Mistral Small 3 e Grok 4 Fast Reasoning sono arrivati a pari merito con 636 punti, con 22 e 20 risultati esatti. OpenAI o4-mini è arrivato terzo, con 634 punti e 22 risultati esatti. Tra i modelli che hanno pronosticato tramite l'interfaccia, la Serie A, il primo posto è andato a ChatGPT 5 Thinking. Due punti di differenza su 104 partite non permettono di affermare che un modello preveda il calcio meglio di un altro.
L'esperimento dimostra che l'IA non serve per la previsione?
No. Dimostra che, nelle condizioni di questo bolão, i modelli sono stati bravi sul risultato atteso e ciechi sull'improbabile, e che gli errori sono arrivati allineati tra loro. Esiste letteratura che mostra come l'aggregazione di più modelli raggiunga una precisione paragonabile a quella delle folle umane in domande binarie con risposta probabilistica (arXiv 2402.19379); è un altro formato di domanda e in esso l'aggregazione funziona. Un bolão richiede un risultato esatto, e lì l'aggregazione spinge tutti verso lo stesso punto.
Dove si trovano i dati dell'esperimento?
Il sito resta online come archivio, con classifica, pronostici partita per partita, consenso e analisi per famiglia di modelli, all'indirizzo bolao.arenadasias.com.br. Il codice è su github.com/giordanorec/bolao-copa-2026. L'esperimento è del gruppo FAROL, del CIn-UFPE, senza scopo di lucro e senza alcun rapporto con case di scommesse; il costo delle API è stato coperto da contributi volontari.