مقال · 2026
ما الذي أخطأت فيه 124 نظام ذكاء اصطناعي في كأس العالم 2026؟
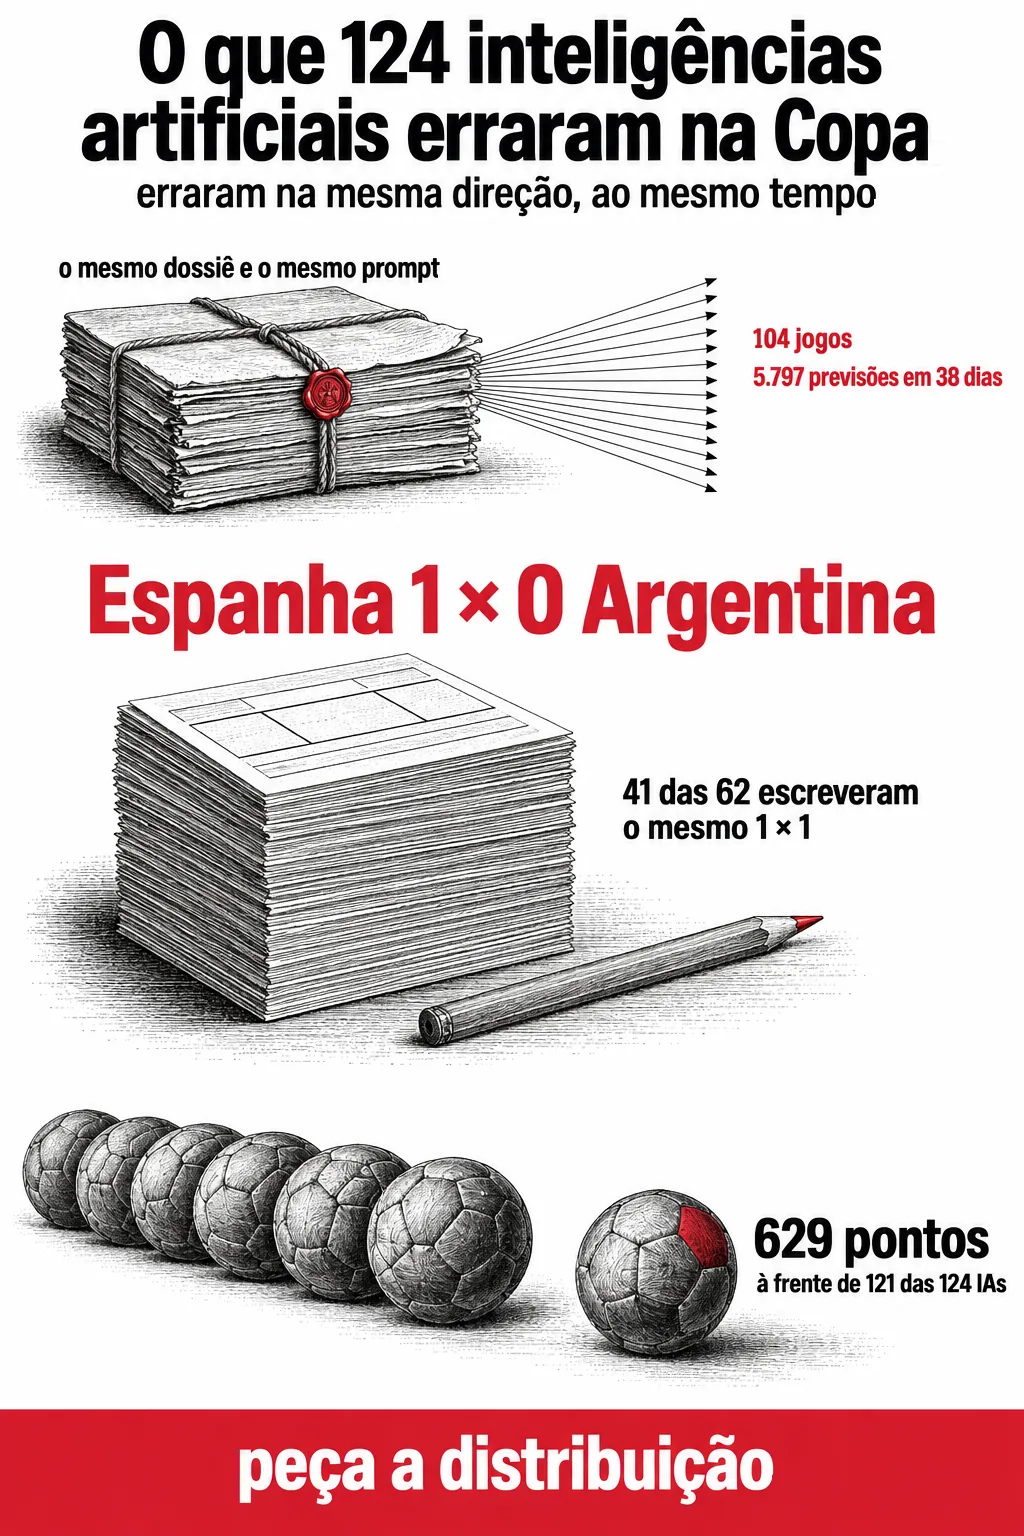
بين 11 يونيو و19 يوليو 2026، تنبّأت 124 نموذجًا للذكاء الاصطناعي بنتائج مباريات كأس العالم الـ104 وفق القواعد نفسها لمسابقة توقعات مكتبية — 5.797 توقعًا في 38 يومًا، مع ترتيب علني. كان إجماع الآلات يرجّح فوز البرازيل باللقب، وخرجت البرازيل في دور الستة عشر أمام النرويج. في نصف النهائي فرنسا 0 × 2 إسبانيا، لم يتوقع أي من أنظمة الذكاء الاصطناعي الـ62 التي أجابت عن تلك المباراة فوز إسبانيا. حقق أفضل مشارك بشري 629 نقطة وأنهى متقدمًا على 121 من أصل 124 نظامًا. جاءت أخطاء النماذج متوافقة: في الاتجاه نفسه وفي الوقت نفسه، مما يقلّل من قيمة استشارة عدة نماذج بوصفها رأيًا ثانيًا.
01 · ما الذي أخطأت فيه 124 نظام ذكاء اصطناعي في كأس العالم
هدف Haaland الثاني
5 يوليو 2026، ملعب MetLife، دور الستة عشر. في الدقيقة 79 افتتح Erling Haaland التسجيل للنرويج؛ وفي الدقيقة 90 سجّل الهدف الثاني. قلّص Neymar الفارق في الوقت بدل الضائع من ركلة جزاء، وغادرت البرازيل كأس العالم مبكرًا أكثر من أي نسخة منذ 1990.
قبل ثلاثة أسابيع، في مقابلة مع Folha de Pernambuco قلت شيئين. الأول: "تميل أنظمة الذكاء الاصطناعي إلى المحافظة الشديدة. فهي تتبع الإحصاءات وتتجنب المخاطر وتميل عادةً إلى التقارب في إجاباتها. أما البشر فيخاطرون أكثر، ويتبعون الحدس، ويستكشفون احتمالات تستبعدها الآلات عادةً." والثاني، بعد أسطر قليلة: "توقعي أن تفوز البرازيل باللقب، مهما بدا ذلك مستبعدًا."
كان إجماع أنظمة الذكاء الاصطناعي الـ124 المشاركة في المسابقة يرجّح فوز البرازيل بكأس العالم، وهو التوقع نفسه الذي قدّمته أنا بصفتي مشجعًا.
02 · ما الذي أخطأت فيه 124 نظام ذكاء اصطناعي في كأس العالم
ما كانت عليه التجربة، وما لا تقيسه
بين 11 يونيو و19 يوليو 2026، كلّفت مجموعة FAROL، التابعة لمركز المعلوماتية في UFPE، 124 نموذجًا للذكاء الاصطناعي بالتنبؤ بنتائج 104 مباريات في كأس العالم. بلغت التوقعات 5.797 توقعًا في 38 يومًا، ضمن ترتيب علني ما زال منشورًا على bolao.arenadasias.com.br وشيفرته المصدرية على github.com/giordanorec/bolao-copa-2026.
التصميم بسيط عن قصد. جمعنا الإحصاءات والأخبار والأداء الأخير والإصابات في ملف واحد، وأرسلنا السياق نفسه والتعليمة نفسها إلى جميع النماذج. عملت الغالبية عبر واجهة برمجة التطبيقات. أما مجموعة فرعية سميناها Série A فقد تنبّأت عبر الواجهة: فتحت المتصفح وبحثت ثم حسمت النتيجة، كما يفعل شخص. وشارك بشر أيضًا في الترتيب نفسه، بموجب اللائحة نفسها، دون أي أفضلية.
قاعدة احتساب النقاط هي قاعدة المسابقة المكتبية: 10 نقاط للنتيجة الدقيقة، و7 للفائز مع فارق الأهداف الصحيح، و5 للفائز دون الفارق، و5 للتعادل دون النتيجة الدقيقة، وصفر لما عدا ذلك. وتتضاعف النقاط في أدوار خروج المغلوب.
ما تقيسه التجربة هو النقاط، وفق قاعدة احتساب اعتباطية، على عيّنة من 104 مباريات: اختبار تنبؤ نقطي في بيئة شديدة عدم اليقين. وهي لا تقيس الذكاء، ولا جودة الاستدلال، ولا المعايرة بالمعنى التقني، الذي يتطلب احتمالات لا نتائج. والترتيب ليس جدولًا لـ"أي نظام ذكاء اصطناعي هو الأفضل".
03 · ما الذي أخطأت فيه 124 نظام ذكاء اصطناعي في كأس العالم
من فاز، وما الذي تخفيه النتيجة
أنهى نظامان للذكاء الاصطناعي في القمة بالتساوي، بـ636 نقطة: Mistral Small 3 بـ22 نتيجة دقيقة، وGrok 4 Fast Reasoning بـ20. وحلّ ثالثًا OpenAI o4-mini بـ634. أما أفضل مشارك بشري، الذي يسمّيه الترتيب العلني Gabriel، فقد حقق 629 نقطة بـ19 نتيجة دقيقة، وأنهى متقدمًا على 121 من 124 نظامًا. وكنت أنا ثاني أفضل مشارك بشري بـ551 نقطة.

في المتوسط، سجّلت الآلات نقاطًا أكثر من البشر؛ أما في القمة، فقد تقدّم شخص واحد على كل الآلات تقريبًا.
تتوقف النتيجة الأولى على طريقة الحساب. فقد بلغ متوسط البشر في مسابقة التوقعات 55 نقطة، مع وسيط صفر، لأن معظم من أنشأوا حسابات لم يضعوا أي توقع قط. ومقارنة متوسط الذكاءات الاصطناعية، التي أجابت عن مباراة تلو الأخرى، بمتوسط البشر، الذين لم يشارك كثير منهم أصلًا، ليست مقارنة حقيقية. المقارنة التي يمكن الدفاع عنها هي في القمة، وفي القمة عدد الأشخاص صغير. وبين من لعبوا فعلًا، يكون فرق الدقة أقل مما يوحي به الترتيب: 15,3% من النتائج المطابقة تمامًا لمجموع الذكاءات الاصطناعية، و15,4% في الدرجة الأولى (Série A)، و11,4% بين البشر.
قاعدة احتساب النقاط تؤثر أيضًا في النتيجة. فقد أصابت البطلة Mistral Small 3 النتيجة الدقيقة في 22 مباراة وحصلت على 636 نقطة؛ وأصابت Grok 4 Fast Reasoning النتيجة الدقيقة في 20 مباراة وحصلت أيضًا على 636 نقطة، في المركز الثاني؛ وأصاب o4-mini النتيجة الدقيقة في 22 مباراة، مثل البطلة، وجاء ثالثًا بـ 634 نقطة. إصابة عدد أكبر من النتائج الدقيقة لم تعنِ نقاطًا أكثر. وما رتّب المنصة هو الجمع بين قيمة فارق الأهداف، والوزن المضاعف للأدوار الإقصائية، وإصابة الفائز، أي قاعدة احتساب النقاط.
04 · ما أخطأت فيه 124 ذكاءً اصطناعيًا في كأس العالم
حيث أخطأت معًا

كان نصف النهائي الذي حسم بطل العالم هو فرنسا 0 × 2 إسبانيا. ومن بين 62 ذكاءً اصطناعيًا أجابت عن تلك المباراة، لم يتوقع أي منها فوز إسبانيا؛ إذ كان الإجماع يشير إلى التعادل. وفي مباراة تحديد المركز الثالث، فرنسا 4 × 6 إنجلترا، عشرة أهداف، لم يصب أي من الـ 63 النتيجة الدقيقة، وخمسة فقط راهنوا أصلًا على فوز إنجلترا. وفي النهائي، إسبانيا 1 × 0 الأرجنتين، الذي حسمه هدف لفيران توريس في الدقيقة الأولى من الوقت الإضافي، كتب 41 من 62 النتيجة نفسها 1 × 1، وهو أكبر إجماع في كل الأدوار الإقصائية. وأصاب سبعة عشر منها النتيجة 1 × 0.
في مرحلة المجموعات كان النمط واضحًا من البداية. فقد كان الإجماع على ألمانيا 7 × 1 كوراساو هو 3 × 0، بـ 41 صوتًا. وعلى قطر 1 × 1 سويسرا كان 0 × 2، بـ 45 صوتًا. وعلى امتداد 104 مباريات، تجاوز 5 فقط من 124 نموذجًا عشرين نتيجة دقيقة؛ وبلغ 7 منها عشرين.
الأهم من معدل الخطأ هو شكل الخطأ. الفرق تخسر، والكرات تدخل المرمى، ولا يَعِد أي متنبّئ جادّ بإصابة نتيجة فرنسا 4 × 6 إنجلترا. وحين أخطأت النماذج، أخطأت في الاتجاه نفسه، وفي الوقت نفسه، وكثيرًا ما كتبت النتيجة نفسها حرفيًا. لو كانت أخطاء 124 متنبّئًا مستقلة، لغطّت المجموعة جزءًا كبيرًا من نطاق النتائج المعقولة، ولأصاب أحدها المفاجأة بحكم البناء. أما عمليًا، فقد تصرّفت المجموعة على نحو يقرب من متنبّئ واحد.
05 · ما أخطأت فيه 124 ذكاءً اصطناعيًا في كأس العالم
لماذا يأتي الخطأ متوافقًا
جزء من التفسير هو قرار منّا، ومن الإنصاف أن نبدأ به. فقد أرسلنا الملف نفسه والتعليمة نفسها إلى الجميع، تحديدًا لتكون المقارنة بين النماذج، لا بين من صاغ السؤال بصورة أفضل. وهذا يخدم المقارنة ويقلّل التنوع: فقد استبعدنا من البداية أحد مصادر التباين التي كانت ستجعل الأخطاء تتباعد.
أما الباقي فمصدره طبيعة هذه الأنظمة. فالنماذج اللغوية المدرَّبة على مدونات متداخلة إلى حد بعيد، والمحسَّنة لإنتاج الاستمرار الأكثر احتمالًا، تجيب عن سؤال "ما ستكون النتيجة" بمنوال توزيعها. ومنوال مباراة كرة القدم مجموعة صغيرة من النتائج: 1 × 0، 1 × 1، 2 × 1. وقاعدة مسابقة التوقعات، من جهتها، تمنح 10 نقاط تحديدًا مقابل الدقة، وتضاعف كل شيء في الأدوار الإقصائية، وهي حيث يتركز غير المحتمل. فالبطولة تكافئ، بوزن مضاعف، المنطقة التي لا يصل إليها المنوال تمامًا.
تساعد الأدبيات في وضع ذلك في سياقه، وهي لا تقول إن النماذج تتنبأ بشكل سيئ. فقد سجّل Schoenegger وPark نموذج GPT-4 في بطولة تنبؤ استمرت ثلاثة أشهر على Metaculus، شارك فيها 843 إنسانًا، وقاسا تنبؤات احتمالية أقل دقة بدرجة ملحوظة من وسيط الحشد البشري (arXiv 2310.13014). وفي العام التالي، جمع Schoenegger وTuminauskaite وPark وTetlock 12 نموذجًا في 31 سؤالًا ثنائيًا وحصلوا على نتيجة لا تختلف إحصائيًا عن نتيجة حشد من 925 متنبّئًا بشريًا (arXiv 2402.19379). وفي هذا الشكل، عوّض التجميع عن الأداء الفردي.
النتيجتان متوافقتان فيما بينهما، ولا تناقض أيٌّ منهما نتيجتنا، لأنهما تقيسان شيئًا آخر. كلتاهما تعملان على احتمالات لأسئلة ثنائية يجري تقييمها بالمعايرة. أما البولاو (مسابقة التوقعات) فيطلب قيمة محددة في فضاء منفصل يضم عشرات النتائج الممكنة، ويكافئ على الدقة. متوسط الاحتمالات عملية تحسّن التقدير؛ أما متوسط التوقعات المحددة فيدفع المجموعة أكثر نحو المنوال، وهو بالضبط المكان الذي لا يوجد فيه غير المتوقع. وهذا ما فعلته «Bola de Cristal» الخاصة بنا حين رشّحت البرازيل بطلةً: الإجماع يعمل كما صُمّم.
06 · ما أخطأت فيه 124 ذكاءً اصطناعيًا في كأس العالم
ما الخطأ في هذه التجربة
للتجربة أربعة قيود، إضافةً إلى ما سبق ذكره: البولاو لا يقيس الذكاء.
سُجّل أقل من نصف التوقعات الممكنة. كان من شأن 124 نموذجًا في 104 مباريات أن تعطي 12.896 توقعًا؛ وسُجّل 5.797. دخلت نماذج في منتصف البطولة، وتوقفت أخرى عن الاستجابة، وفشلت غيرها. ومن هنا يتغير المقام من مباراة إلى أخرى: 62 في نصف النهائي، و63 في مباراة المركز الثالث، و124 في المجموع. «لا أحد من الـ62» و«5 من الـ124» ليستا جملتين عن المجموعة نفسها.
العينة البشرية ليست عينة. الوسيط صفر يُظهر ذلك. لم يكن هناك تجنيد ولا معيار، ومن دخل دخل لأنه رأى الرابط.
الترتيب نتاج مصطنع لقاعدة احتساب النقاط. إذا تغيّر جدول 10-7-5 تحرّك منصة التتويج؛ ومقياس بريير (Brier) كان سيكافئ المعايرة وينتج ترتيبًا آخر وفائزًا آخر. اخترنا القاعدة التي يلعب بها الناس في المكتب، وهذا يجعل التجربة مقروءة، وفي الوقت نفسه معتمدة على اصطلاح لا صفة علمية له.
كأس العالم 104 مباريات. وهذا قليل للفصل بين الكفاءة والحظ. بين صاحبة المركز الأول وصاحبة المركز الثالث كان الفارق نقطتين. لا تسمح هذه البيانات بالقول إن Mistral Small 3 يتوقع كرة القدم أفضل من o4-mini؛ فقد سجّل نقطتين أكثر، في كأس عالم واحدة.
07 · ما أخطأت فيه 124 ذكاءً اصطناعيًا في كأس العالم
النتائج المترتبة على استخدام الذكاء الاصطناعي في العمل
الأولى أن سؤال عدة نماذج عن الأمر نفسه ليس رأيًا ثانيًا. اتفاق أنظمة دُرّبت على مواد متشابهة، وتقرأ السياق نفسه، وجرى تحسينها لنوع الإجابة نفسه، يقيس شيوع الإجابة. وهو يشبه التأكيد كثيرًا: خمسة نماذج تقول الشيء نفسه تولّد شعورًا بالأمان لا تسنده البيانات. يجب أن يدخل التباين عبر السؤال: تصاميم مختلفة، وفرضيات مناقضة، وأشخاص يخالفون الرأي.
الثانية أن النموذج يساعد أقل تحديدًا حيث تُتخذ القرارات. في المباريات ذات المسار المتوقع كانت أنظمة الذكاء الاصطناعي جيدة؛ وفي أربع أو خمس مباريات حسمت مجرى البطولة كانت بالإجماع على خطأ. والعمل له الشكل نفسه. الحالة الروتينية، التي تتفوق فيها، هي أيضًا الحالة التي يكلّف الخطأ فيها قليلًا؛ أما الاستثناء مرتفع الكلفة فهو الذي لم تتوقعه.
الثالثة تشغيلية: اطلب التوزيع. «ما ستكون النتيجة» تعيد المنوال. أما «ما أكثر خمس نتائج احتمالًا وبأي وزن» فتعيد شيئًا يمكن العمل به، بما في ذلك المعلومة بأن النموذج لا يملك أي تصور. هذا هو الفرق بين تقدير نقطي وتقدير معلن عن عدم اليقين، وهو ما يتيح إدراك أن الإجابة تخمين قبل التصرف بناءً عليها. نبرة الإجابة لا تدل على ذلك: النموذج يكتب «البرازيل بطلة» بالهدوء نفسه الذي يكتب به «ألمانيا تفوز على كوراساو»، ولا شيء في الجملة يميّز بين الحالتين.
في يونيو، حين بدأ البولاو، لخّصتُ ذلك لصحيفة Folha de Pernambuco بطريقة لا تزال تبدو لي صحيحة: «الذكاء الاصطناعي ليس عرّافًا يتنبأ بالمستقبل، بل أداة لاتخاذ قرارات أفضل في بيئات يسودها عدم اليقين». وقد عزّزت كأس العالم النصف الثاني من الجملة.
08 · ما أخطأت فيه 124 ذكاءً اصطناعيًا في كأس العالم
Gabriel
أحرز Gabriel 629 نقطة و19 نتيجة دقيقة. لم يتلقَّ الملف الذي أعددناه للآلات، ولم يُجب عن المطالبة (prompt) الخاصة بنا، ولم يخضع لأي انتقاء: دخل بولاو عبر الإنترنت، كما يدخل المرء أي بولاو. وأنهى متقدمًا على 121 من أصل 124 نظامًا من أقدر الأنظمة على معالجة النصوص التي استطعنا جمعها.
لا يمكن القول لماذا فاز. فمئة وأربع مباريات لا تفصل بين الكفاءة والحظ، وفرضية أنه كان محظوظًا ببساطة تتوافق مع كل ما قسناه، كما تتوافق، بالمناسبة، مع حصولي على المركز الثاني. ما بقي مسجَّلًا هو أنه، بين 124 نموذجًا قرأت المادة نفسها وكتبت، في معظمها، التوقع نفسه، جاء الفارق الذي حسم البطولة من خارج تلك المجموعة.
في 22 يوليو جمّدنا الموقع كأرشيف عام. وما زال هناك: الترتيب، والتوقعات مباراةً بمباراة، والإجماع، والمفاجآت، والأخطاء.
الأسئلة الشائعة
كم ذكاءً اصطناعيًا شارك في البولاو؟
مئة وأربعة وعشرون، وفق العدّ عند الإغلاق في 22 de julho de 2026. دخلت نماذج وخرجت أخرى على امتداد الأيام الثمانية والثلاثين؛ ولذلك يختلف عدد الإجابات من مباراة إلى أخرى، وبلغ إجمالي التوقعات المسجّلة 5.797.
هل كانت أنظمة الذكاء الاصطناعي أفضل من البشر أم أسوأ؟
يعتمد ذلك على زاوية النظر، والإجابتان صحيحتان. في المجموع، حصدت أنظمة الذكاء الاصطناعي نقاطًا أكثر: بلغ متوسط السلسلة A 537 نقطة، ومتوسط جميع الأنظمة 458. وعلى القمة، سجّل أفضل مشارك بشري 629 نقطة وتقدّم على 121 من أصل 124 نظامًا. أما المتوسط البشري المنشور (55 نقطة، والوسيط صفر) فلا ينبغي استخدامه في المقارنة: فأغلب من سجّلوا أسماءهم لم يتوقعوا شيئًا قط.
لماذا لم يتوقع أي نظام ذكاء اصطناعي فوز إسبانيا على فرنسا؟
لأن جميعها تلقّت السياق نفسه، وتقاربت كلها نحو النتيجة الأرجح بحسب البيانات المتاحة، وكانت تشير إلى تكافؤ: فقد كان إجماع تلك المباراة هو التعادل. إن نموذج اللغة الذي يُطلب منه نتيجة واحدة يعيد منوال توزيعه، والمنوال، بحكم تعريفه، لا يشمل النتيجة غير المرجّحة. ومن بين 62 نظامًا أجابت عن تلك المباراة في نصف النهائي، لم يتوقع أي منها فوز إسبانيا.
أي نموذج فاز بمسابقة التوقعات؟
تعادل Mistral Small 3 وGrok 4 Fast Reasoning عند 636 نقطة، مع 22 و20 نتيجة دقيقة. وجاء OpenAI o4-mini ثالثًا بـ634 نقطة و22 نتيجة دقيقة. ومن بين النماذج التي توقعت عبر الواجهة، وهي السلسلة A، كان المركز الأول لـChatGPT 5 Thinking. ولا يتيح فارق نقطتين في 104 مباريات القول إن نموذجًا يتنبأ بكرة القدم أفضل من غيره.
هل تثبت التجربة أن الذكاء الاصطناعي لا يصلح للتنبؤ؟
لا. إنها تثبت أنه، في ظروف هذه المسابقة، أحسنت النماذج في النتيجة المتوقعة وعجزت عن غير المرجّح، وأن أخطاءها جاءت متوافقة فيما بينها. وتوجد دراسات تبيّن أن تجميع عدة نماذج يبلغ دقة مماثلة لدقة الحشود البشرية في الأسئلة الثنائية ذات الجواب الاحتمالي (arXiv 2402.19379)؛ وهذه صيغة سؤال مختلفة، والتجميع ينجح فيها. أما مسابقة التوقعات فتطلب نتيجة دقيقة، وهنا يدفع التجميع الجميع إلى الموضع نفسه.
أين توجد بيانات التجربة؟
ما زال الموقع متاحًا كأرشيف، ويضم الترتيب والتوقعات مباراةً بمباراة والإجماع وتحليلًا لكل عائلة من النماذج، على العنوان bolao.arenadasias.com.br. والشيفرة المصدرية على github.com/giordanorec/bolao-copa-2026. التجربة من مجموعة FAROL في CIn-UFPE، غير ربحية ولا صلة لها بشركات المراهنات؛ وقد غُطّيت تكلفة واجهات البرمجة بمساهمات طوعية.