Essai · 2026
Qu'est-ce que 124 intelligences artificielles ont raté à la Coupe du monde 2026 ?
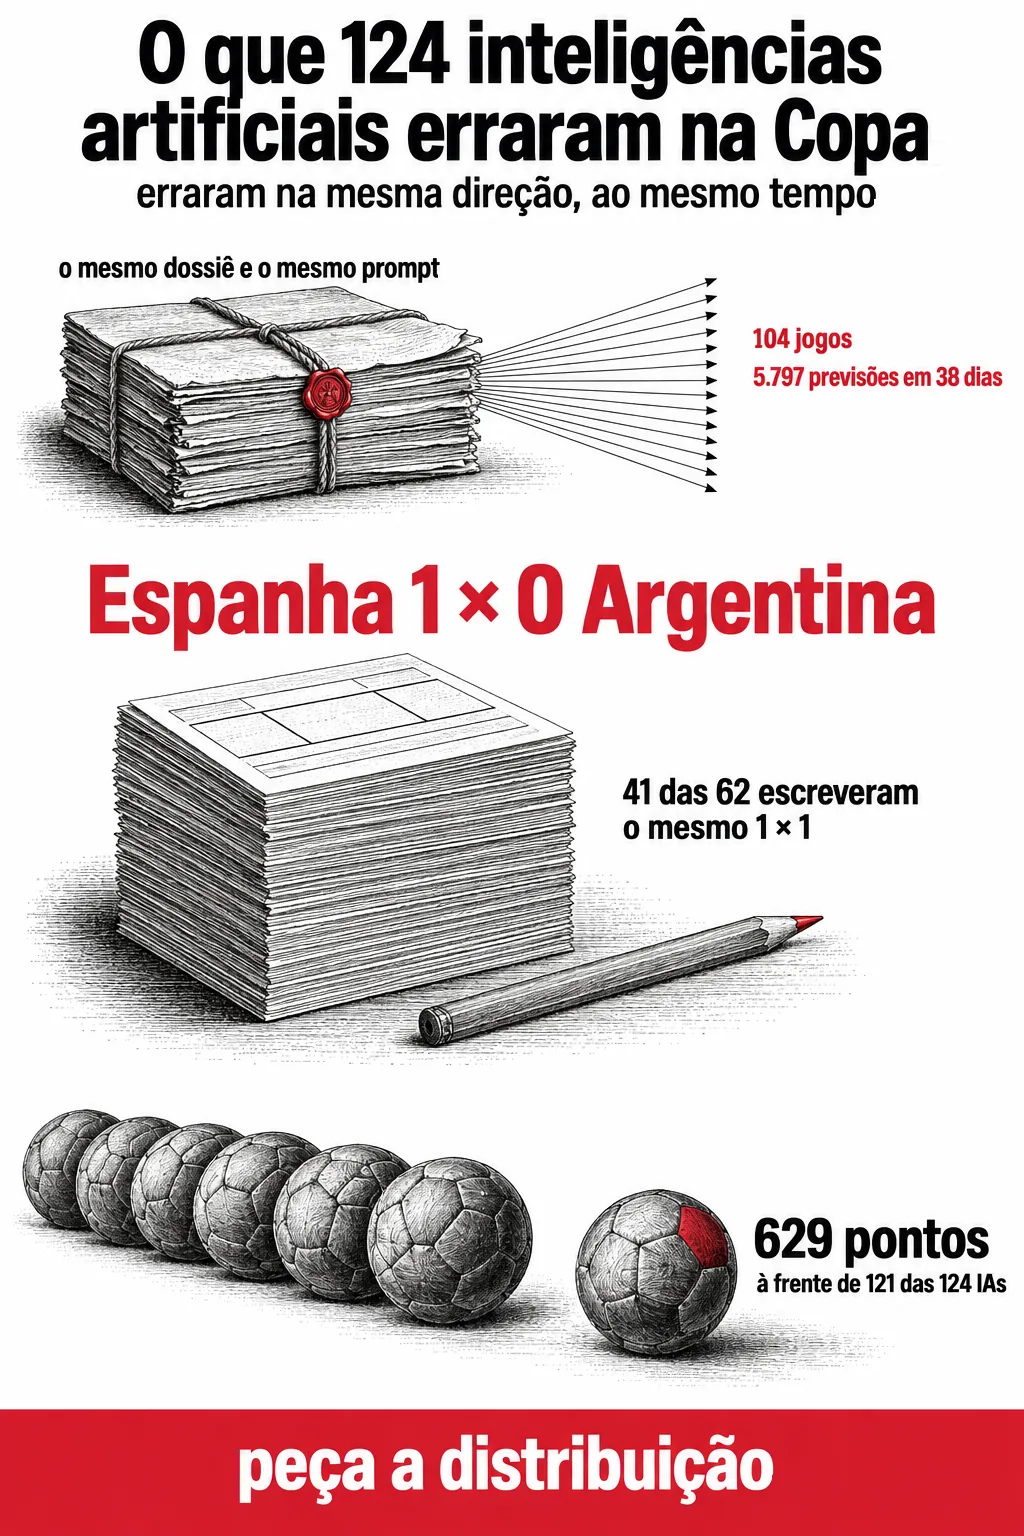
Entre le 11 juin et le 19 juillet 2026, 124 modèles d'intelligence artificielle ont pronostiqué les 104 matchs de la Coupe du monde selon les mêmes règles qu'un concours de pronostics de bureau — 5 797 prévisions en 38 jours, avec un classement ouvert. Le consensus des machines donnait le Brésil champion, et le Brésil a été éliminé en huitièmes par la Norvège. En demi-finale France 0 × 2 Espagne, aucune des 62 IA ayant répondu pour ce match n'a prévu la victoire espagnole. Le meilleur participant humain a totalisé 629 points et a terminé devant 121 des 124 IA. Les erreurs des modèles étaient alignées : dans la même direction et au même moment, ce qui réduit l'intérêt de consulter plusieurs modèles comme second avis.
01 · Ce que 124 intelligences artificielles ont raté à la Coupe du monde
Le deuxième but de Haaland
Le 5 juillet 2026, MetLife Stadium, huitièmes de finale. À la 79e minute, Erling Haaland ouvre le score pour la Norvège ; à la 90e, il inscrit le deuxième. Neymar réduit l'écart dans les arrêts de jeu, sur penalty, et le Brésil quitte la Coupe du monde plus tôt que lors de n'importe quelle édition depuis 1990.
Trois semaines plus tôt, dans une interview à la Folha de Pernambuco, j'avais dit deux choses. La première : « les IA ont tendance à être très conservatrices. Elles suivent les statistiques, évitent les risques et convergent souvent vers des réponses semblables. Les humains, en revanche, prennent plus de risques, suivent leur intuition et explorent des possibilités que les machines écartent normalement. » La seconde, quelques lignes plus loin : « mon espérance est le Brésil champion, aussi improbable que cela soit. »
Le consensus des 124 intelligences artificielles participant au concours désignait le Brésil champion du monde, le même pronostic que moi, en tant que supporter, j'avais fait.
02 · Ce que 124 intelligences artificielles ont raté à la Coupe du monde
Ce qu'était l'expérience, et ce qu'elle ne mesure pas
Entre le 11 juin et le 19 juillet 2026, le groupe FAROL, du Centre d'informatique de l'UFPE, a fait pronostiquer les 104 matchs de la Coupe du monde par 124 modèles d'intelligence artificielle. Cela a donné 5 797 prévisions en 38 jours, dans un classement ouvert toujours publié sur bolao.arenadasias.com.br et dont le code se trouve sur github.com/giordanorec/bolao-copa-2026.
Le dispositif est volontairement simple. Nous avons réuni statistiques, actualités, performances récentes et blessures dans un dossier unique, et envoyé le même contexte et le même prompt à tous les modèles. La plupart ont tourné par API. Un sous-ensemble, que nous appelons Série A, a pronostiqué via l'interface : il a ouvert le navigateur, fait des recherches, puis arrêté le score, comme le ferait une personne. Des personnes figuraient dans le même classement, sous le même règlement, sans handicap.
La règle de points est celle du concours de bureau : 10 points pour le score exact, 7 pour le vainqueur avec la bonne différence de buts, 5 pour le vainqueur sans la différence, 5 pour le match nul sans le score exact et zéro pour le reste. Tout est doublé en phase à élimination directe.
Ce qu'il mesure, ce sont des points, selon une règle de comptage arbitraire, sur un échantillon de 104 matchs : un test de prévision ponctuelle dans un environnement de forte incertitude. Il ne mesure ni l'intelligence, ni la qualité du raisonnement, ni la calibration au sens technique, qui exigerait des probabilités et non des scores. Le classement n'est pas un tableau de « quelle IA est la meilleure ».
03 · Ce que 124 intelligences artificielles ont raté à la Coupe du monde
Qui a gagné, et ce que le score cache
Deux IA ont terminé à égalité en tête, avec 636 points : Mistral Small 3, avec 22 scores exacts, et Grok 4 Fast Reasoning, avec 20. La troisième, OpenAI o4-mini, a fait 634. Le meilleur participant humain, que le classement public désigne comme Gabriel, a fait 629 points avec 19 scores exacts, et a terminé devant 121 des 124 IA. J'ai été le deuxième humain, avec 551.

En moyenne, les machines ont obtenu plus de points que les personnes ; au sommet, une personne a devancé presque toutes les machines.
Le premier constat dépend de la manière de compter. La moyenne des humains dans le bolão a été de 55 points, avec une médiane de zéro, parce que la plupart de ceux qui ont créé un compte n'ont jamais fait de pronostic. Comparer la moyenne des IA, qui ont répondu match après match, à la moyenne des humains, qui pour une bonne part n'ont pas joué, ne compare rien. La comparaison qui tient se fait au sommet, et au sommet le nombre de personnes est faible. Parmi ceux qui ont réellement joué, l'écart de précision est plus modeste que ne le laisse penser le classement : 15,3 % de scores exacts pour l'ensemble des IA, 15,4 % en Série A, 11,4 % chez les humains.
Le règlement de points pèse aussi sur le résultat. La championne Mistral Small 3 a trouvé 22 scores exacts et totalisé 636 points ; Grok 4 Fast Reasoning en a trouvé 20 et a aussi totalisé 636, en deuxième position ; o4-mini en a trouvé 22, comme la championne, et termine troisième avec 634. Plus de scores exacts n'ont pas donné plus de points. Ce qui a ordonné le podium, c'est la combinaison entre la valeur de la différence de buts, le poids doublé de la phase à élimination directe et la justesse du vainqueur, c'est-à-dire le règlement de points.
04 · Ce que 124 intelligences artificielles ont raté à la Coupe du monde
Là où elles se sont trompées ensemble

La demi-finale qui a désigné la championne du monde était France 0 × 2 Espagne. Sur les 62 IA qui ont répondu pour ce match, aucune n'a prévu la victoire espagnole ; le consensus indiquait un match nul. Lors du match pour la troisième place, France 4 × 6 Angleterre, dix buts, aucune des 63 n'a trouvé le score exact et seules cinq ont ne serait-ce que parié sur la victoire anglaise. En finale, Espagne 1 × 0 Argentine, décidée par un but de Ferran Torres à la première minute de la prolongation, 41 des 62 ont écrit le même 1 × 1, le plus grand consensus de toute la phase à élimination directe. Dix-sept ont trouvé le 1 × 0.
En phase de groupes, le schéma était déjà en place. Le consensus pour Allemagne 7 × 1 Curaçao était 3 × 0, avec 41 votes. Pour Qatar 1 × 1 Suisse, c'était 0 × 2, avec 45. Sur les 104 matchs, seuls 5 des 124 modèles ont dépassé vingt scores exacts ; 7 ont atteint vingt.
Plus significative que le taux d'erreur, c'est la forme de l'erreur. Des équipes perdent, des ballons entrent, et aucun prévisionniste sérieux ne promettrait de trouver France 4 × 6 Angleterre. Quand elles se sont trompées, elles l'ont fait dans la même direction, au même moment, et souvent en écrivant littéralement le même score. Si les erreurs de 124 prévisionnistes étaient indépendantes, l'ensemble couvrirait une bonne partie de l'espace des résultats plausibles et quelqu'un trouverait la surprise par construction. En pratique, l'ensemble s'est comporté à peu près comme un seul prévisionniste.
05 · Ce que 124 intelligences artificielles ont raté à la Coupe du monde
Pourquoi l'erreur est alignée
Une partie de l'explication tient à notre décision, et il est juste de commencer par elle. Nous avons envoyé le même dossier et le même prompt à tous, précisément pour que la comparaison porte sur les modèles, et non sur celui qui a le mieux rédigé la question. Cela favorise la comparaison et réduit la diversité : nous avons éliminé d'emblée l'une des sources de variation qui feraient diverger les erreurs.
Le reste vient de ce que sont ces systèmes. Des modèles de langage entraînés sur des corpus largement recoupés, optimisés pour produire la suite la plus probable, répondent à « quel sera le score » par le mode de leur distribution. Or le mode d'un match de football est un petit ensemble de scores : 1 × 0, 1 × 1, 2 × 1. Le règlement du bolão, de son côté, accorde 10 points précisément pour l'exactitude, et double tout en phase à élimination directe, là où se concentre l'improbable. Le tournoi récompense, avec un poids double, exactement la région que le mode n'atteint pas.
La littérature aide à situer cela, et elle ne dit pas que les modèles prévoient mal. Schoenegger et Park ont inscrit GPT-4 à un tournoi de prévision de trois mois sur Metaculus, avec 843 participants humains, et ont mesuré des prévisions probabilistes significativement moins précises que la médiane de la foule humaine (arXiv 2310.13014). L'année suivante, Schoenegger, Tuminauskaite, Park et Tetlock ont agrégé 12 modèles sur 31 questions binaires et obtenu un résultat statistiquement indiscernable de celui d'une foule de 925 prévisionnistes humains (arXiv 2402.19379). Dans ce format, l'agrégation a compensé la performance individuelle.
Les deux résultats sont compatibles entre eux, et aucun ne contredit le nôtre, car ils mesurent autre chose. Tous deux portent sur des probabilités relatives à des questions binaires, évaluées par calibration. Un pronostic de concours demande une valeur ponctuelle dans un espace discret de plusieurs dizaines de résultats possibles et récompense l'exactitude. La moyenne de probabilités est une opération qui améliore l'estimation ; la moyenne de pronostics ponctuels pousse l'ensemble encore davantage vers le mode, qui est précisément l'endroit où l'improbable ne se trouve pas. C'est ce qu'a fait notre Bola de Cristal en désignant le Brésil champion : le consensus fonctionnant comme prévu.
06 · Ce que 124 intelligences artificielles ont raté à la Coupe du monde
Ce qui ne va pas dans cette expérience
L'expérience comporte quatre limites, en plus de celle déjà mentionnée : un concours de pronostics ne mesure pas l'intelligence.
Moins de la moitié des pronostics possibles a été enregistrée. Cent vingt-quatre modèles fois 104 matchs auraient donné 12 896 prévisions ; il y en a eu 5 797. Des modèles sont entrés en cours de tournoi, ont cessé de répondre, ont échoué. D'où un dénominateur qui change d'un match à l'autre : 62 en demi-finale, 63 pour la petite finale, 124 dans l'agrégat. « Aucun des 62 » et « 5 des 124 » ne sont pas des phrases portant sur le même ensemble.
L'échantillon humain n'est pas un échantillon. La médiane de zéro le montre. Il n'y a eu ni recrutement ni critère, et ceux qui sont entrés l'ont fait parce qu'ils ont vu le lien.
Le classement est un artefact de la règle de notation. Si l'on change le barème 10-7-5, le podium bouge ; un score de Brier récompenserait la calibration et produirait un autre ordre, avec un autre vainqueur. Nous avons choisi la règle que les gens jouent au bureau, ce qui rend l'expérience lisible et, dans la même mesure, dépendante d'une convention sans statut scientifique.
Une Coupe du monde, ce sont 104 matchs. C'est peu pour séparer la compétence de la chance. Entre la première et la troisième place, il y a eu deux points d'écart. Ces données ne permettent pas de dire si Mistral Small 3 prédit le football mieux que o4-mini ; il a fait deux points de plus, lors d'une seule Coupe du monde.
07 · Ce que 124 intelligences artificielles ont raté à la Coupe du monde
Conséquences pour l'usage de l'IA au travail
La première est que poser la même question à plusieurs modèles ne constitue pas un deuxième avis. L'accord entre des systèmes entraînés sur des données voisines, lisant le même contexte et optimisés pour le même type de réponse, mesure la popularité de la réponse. Et il ressemble beaucoup à une confirmation : cinq modèles qui disent la même chose produisent un sentiment de sécurité que les données ne soutiennent pas. La variance doit entrer par la question : des cadrages différents, des hypothèses adverses, des personnes qui ne sont pas d'accord.
La deuxième est que le modèle aide le moins précisément là où la décision se prend. Dans les matchs au scénario prévisible, les IA ont été bonnes ; c'est dans les quatre ou cinq rencontres qui ont fait basculer la Coupe qu'elles ont été unanimes et dans l'erreur. Le travail a la même forme. Le cas courant, où elles sont excellentes, est aussi celui où l'erreur coûte peu ; l'exception à fort coût est celle qu'elles n'ont pas prévue.
La troisième est opérationnelle : demandez la distribution. « Quel sera le score ? » renvoie le mode. « Quels sont les cinq scores les plus probables, et avec quel poids ? » renvoie quelque chose avec quoi l'on peut travailler, y compris l'information que le modèle n'en a aucune idée. C'est la différence entre une estimation ponctuelle et une estimation dont l'incertitude est déclarée, et c'est ce qui permet de voir que la réponse est une supposition avant d'agir dessus. Le ton de la réponse ne l'indique pas : un modèle écrit « Brésil champion » avec la même sérénité que « l'Allemagne bat Curaçao », et rien dans la phrase ne distingue les deux cas.
En juin, lorsque le concours a commencé, j'ai résumé cela à la Folha de Pernambuco d'une manière qui me paraît toujours juste : « l'IA n'est pas un oracle qui prédit l'avenir, c'est un outil pour prendre de meilleures décisions dans des environnements d'incertitude ». La Coupe du monde a renforcé la seconde moitié de la phrase.
08 · Ce que 124 intelligences artificielles ont raté à la Coupe du monde
Gabriel
Gabriel a totalisé 629 points et 19 scores exacts. Il n'a pas reçu le dossier que nous avons constitué pour les machines, n'a pas répondu à notre prompt et n'a fait l'objet d'aucune curation : il est entré dans un concours de pronostics sur internet, comme on entre dans n'importe quel concours. Il a terminé devant 121 des 124 systèmes les plus capables de traiter du texte que nous ayons pu réunir.
Il est impossible de dire pourquoi il a gagné. Cent quatre matchs ne séparent pas la compétence de la chance, et l'hypothèse selon laquelle il a simplement eu de la chance est compatible avec tout ce que nous avons mesuré, comme elle l'est, du reste, avec ma deuxième place. Ce qui reste établi, c'est que, parmi 124 modèles qui ont lu le même matériau et écrit, en grande partie, le même pronostic, la différence qui a décidé du tournoi est venue de l'extérieur de cet ensemble.
Le 22 juillet, nous avons figé le site comme archive publique. Il reste en ligne : le classement, les pronostics match par match, le consensus, les surprises et les erreurs.
Questions fréquentes
Combien d'intelligences artificielles ont participé au concours de pronostics ?
Cent vingt-quatre, au décompte de clôture, le 22 juillet 2026. Des modèles sont entrés et sortis au cours des 38 jours ; c'est pourquoi le nombre de réponses varie d'un match à l'autre, et le total de pronostics enregistrés s'est élevé à 5 797.
Les intelligences artificielles ont-elles fait mieux ou moins bien que les humains ?
Cela dépend de l'endroit où l'on regarde, et les deux réponses sont vraies. Dans l'ensemble, les IA ont obtenu plus de points : la moyenne de la Série A a été de 537 points et celle de toutes les IA, de 458. Au sommet, le meilleur humain a fait 629 points et a devancé 121 des 124. La moyenne humaine publiée (55 points, médiane zéro) ne doit pas être utilisée pour la comparaison : la plupart de ceux qui se sont inscrits n'ont jamais pronostiqué.
Pourquoi aucune IA n'a-t-elle prédit la victoire de l'Espagne sur la France ?
Parce que toutes ont reçu le même contexte et toutes ont convergé vers le résultat le plus probable selon les données disponibles, qui indiquaient un équilibre : le consensus de ce match était le match nul. Un modèle de langage à qui l'on demande un score unique renvoie le mode de sa distribution, et le mode, par définition, ne couvre pas le résultat improbable. Sur les 62 IA qui ont répondu pour cette demi-finale, aucune n'a prédit une victoire espagnole.
Quel modèle a remporté le bolão ?
Mistral Small 3 et Grok 4 Fast Reasoning sont à égalité avec 636 points, avec 22 et 20 scores exacts. OpenAI o4-mini est troisième, avec 634 points et 22 scores exacts. Parmi les modèles qui ont pronostiqué via l'interface, la Série A, la première place est revenue à ChatGPT 5 Thinking. Deux points d'écart sur 104 matchs ne permettent pas d'affirmer qu'un modèle prédit mieux le football qu'un autre.
L'expérience prouve-t-elle que l'IA ne sert pas à la prévision ?
Non. Elle prouve que, dans les conditions de ce bolão, les modèles ont été bons sur le résultat attendu et aveugles à l'improbable, et que leurs erreurs sont allées dans le même sens. Une littérature montre que l'agrégation de plusieurs modèles atteint une précision comparable à celle des foules humaines sur des questions binaires à réponse probabiliste (arXiv 2402.19379) ; c'est un autre format de question, et l'agrégation y fonctionne. Un bolão demande un score exact, et là l'agrégation pousse tout le monde vers le même endroit.
Où se trouvent les données de l'expérience ?
Le site reste en ligne comme archive, avec le classement, les pronostics match par match, le consensus et l'analyse par famille de modèles, à l'adresse bolao.arenadasias.com.br. Le code est disponible à l'adresse github.com/giordanorec/bolao-copa-2026. L'expérience est menée par le groupe FAROL, du CIn-UFPE, sans but lucratif et sans lien avec des maisons de paris ; le coût des API a été couvert par des contributions volontaires.