Essay · 2026
Was haben 124 künstliche Intelligenzen bei der Weltmeisterschaft 2026 falsch vorhergesagt?
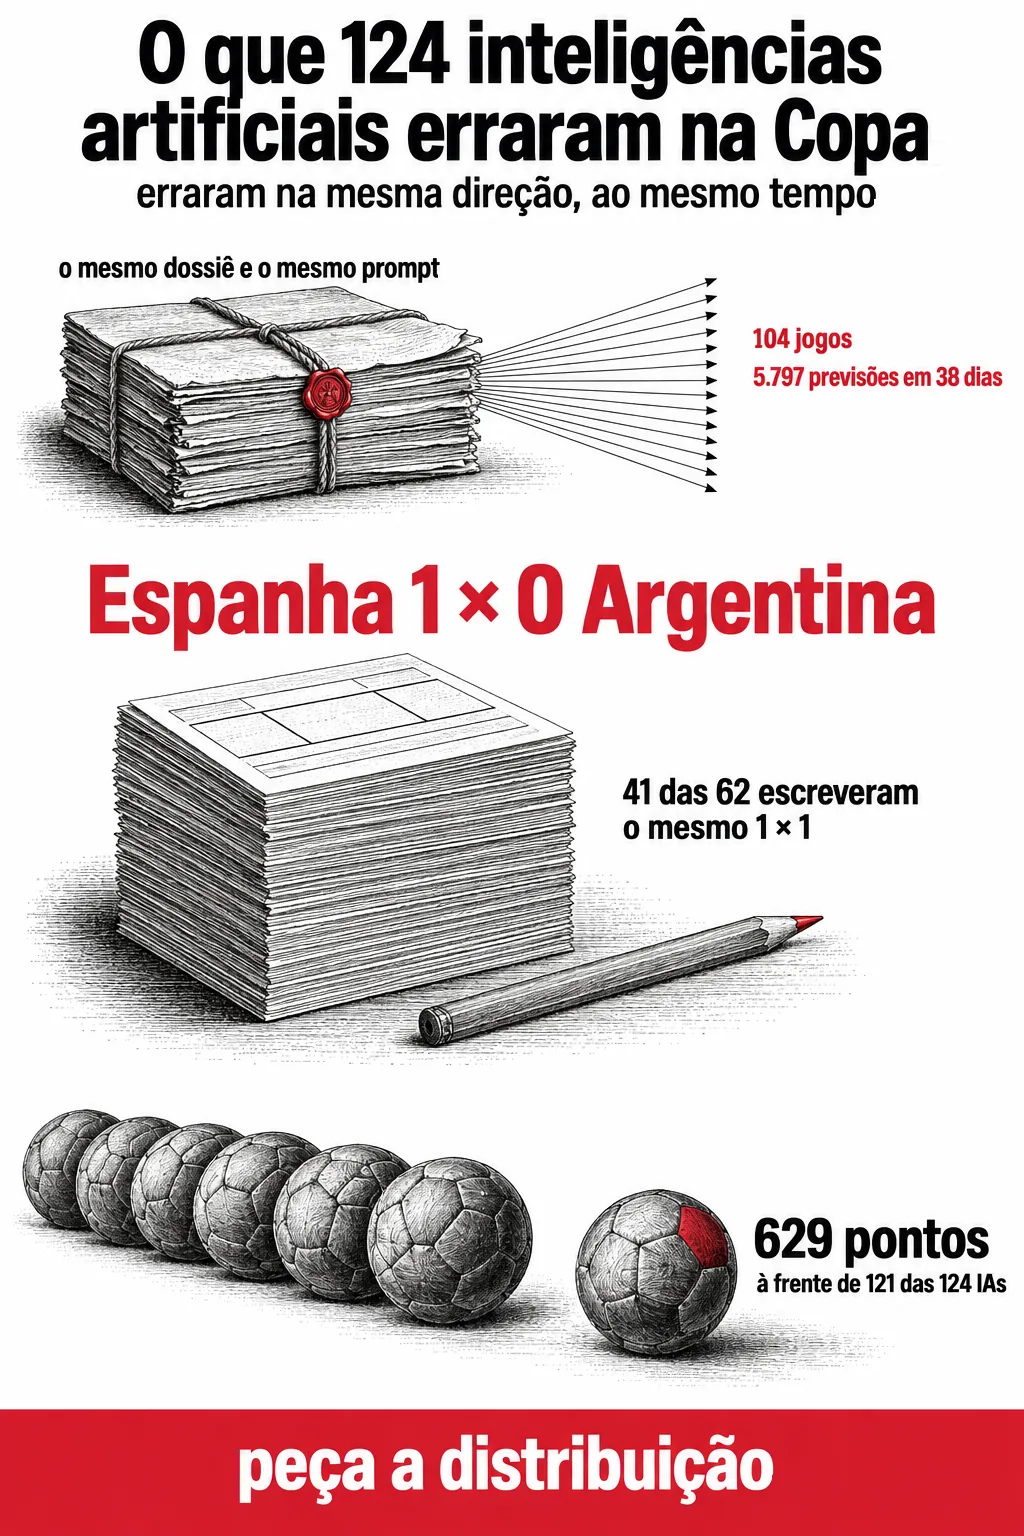
Zwischen dem 11. Juni und dem 19. Juli 2026 tippten 124 Modelle künstlicher Intelligenz alle 104 Spiele der Weltmeisterschaft 2026 nach denselben Regeln wie ein Bürotippspiel — 5.797 Vorhersagen in 38 Tagen, mit offenem Ranking. Der Konsens der Maschinen sah Brasilien als Weltmeister, und Brasilien schied im Achtelfinale gegen Norwegen aus. Im Halbfinale Frankreich 0 × 2 Spanien sagte keine der 62 KIs, die dieses Spiel getippt hatten, den spanischen Sieg voraus. Der beste menschliche Teilnehmer erzielte 629 Punkte und landete vor 121 der 124 KIs. Die Fehler der Modelle waren gleichgerichtet: in dieselbe Richtung und zur selben Zeit, was den Wert mindert, mehrere Modelle als Zweitmeinung zu befragen.
01 · Was 124 künstliche Intelligenzen bei der WM falsch vorhersagten
Haalands zweites Tor
Der 5. Juli 2026, MetLife Stadium, Achtelfinale. In der 79. Minute brachte Erling Haaland Norwegen in Führung; in der 90. erzielte er das zweite Tor. Neymar verkürzte in der Nachspielzeit per Elfmeter, und Brasilien schied früher aus der Weltmeisterschaft aus als bei jeder Ausgabe seit 1990.
Drei Wochen zuvor hatte ich in einem Interview mit der Folha de Pernambuco zwei Dinge gesagt. Das erste: „KIs sind tendenziell sehr konservativ. Sie folgen den Statistiken, meiden Risiken und konvergieren in der Regel zu ähnlichen Antworten. Menschen hingegen gehen mehr Risiken ein, folgen Intuitionen und erkunden Möglichkeiten, die Maschinen normalerweise verwerfen.“ Das zweite, wenige Zeilen später: „Ich erwarte Brasilien als Weltmeister, so unwahrscheinlich das auch sein mag.“
Der Konsens der 124 künstlichen Intelligenzen, die am Tippspiel teilnahmen, sah Brasilien als Weltmeister, denselben Tipp, den ich als Fan abgegeben hatte.
02 · Was 124 künstliche Intelligenzen bei der WM falsch vorhersagten
Was das Experiment war und was es nicht misst
Zwischen dem 11. Juni und dem 19. Juli 2026 ließ die Gruppe FAROL des Informatikzentrums der UFPE 124 Modelle künstlicher Intelligenz die 104 Spiele der Weltmeisterschaft tippen. Es entstanden 5.797 Vorhersagen in 38 Tagen in einem offenen Ranking, das weiterhin unter bolao.arenadasias.com.br veröffentlicht ist und dessen Code unter github.com/giordanorec/bolao-copa-2026 liegt.
Der Aufbau ist bewusst einfach. Wir fassten Statistiken, Nachrichten, die jüngste Form und Verletzungen in einem einzigen Dossier zusammen und schickten denselben Kontext und denselben Prompt an alle Modelle. Die meisten liefen über eine API. Eine Teilmenge, die wir Serie A nennen, tippte über die Benutzeroberfläche: Sie öffnete den Browser, recherchierte und legte sich dann auf das Ergebnis fest, wie es ein Mensch täte. Auch Menschen traten im selben Ranking an, nach demselben Regelwerk und ohne Handicap.
Die Punktewertung ist die eines Bürotippspiels: 10 Punkte für das exakte Ergebnis, 7 für den richtigen Sieger mit der richtigen Tordifferenz, 5 für den richtigen Sieger ohne die Tordifferenz, 5 für das Unentschieden ohne das exakte Ergebnis und null für alles andere. In der K.-o.-Phase wird alles verdoppelt.
Gemessen werden Punkte, nach einer willkürlichen Zählregel, an einer Stichprobe von 104 Spielen: ein Test punktueller Vorhersage unter hoher Unsicherheit. Es misst weder Intelligenz noch die Qualität des Denkens noch Kalibrierung im technischen Sinn, die Wahrscheinlichkeiten statt Ergebnissen erfordern würde. Das Ranking ist keine Tabelle darüber, „welche KI besser ist“.
03 · Was 124 künstliche Intelligenzen bei der WM falsch vorhersagten
Wer gewonnen hat und was das Ergebnis verbirgt
Zwei KIs lagen gleichauf an der Spitze, mit 636 Punkten: Mistral Small 3 mit 22 exakten Ergebnissen und Grok 4 Fast Reasoning mit 20. Die Drittplatzierte, OpenAI o4-mini, erzielte 634. Der beste menschliche Teilnehmer, den das öffentliche Ranking Gabriel nennt, erzielte 629 Punkte mit 19 exakten Ergebnissen und landete vor 121 der 124 KIs. Ich war der zweitbeste Mensch, mit 551.

Im Durchschnitt erzielten die Maschinen mehr Punkte als die Menschen; an der Spitze lag eine Person vor fast allen Maschinen.
Die erste Feststellung hängt davon ab, wie man zählt. Der Durchschnitt der Menschen im Tippspiel lag bei 55 Punkten, mit einem Median von null, weil die meisten, die ein Konto angelegt haben, nie getippt haben. Den Durchschnitt der KIs, die Spiel für Spiel geantwortet haben, mit dem Durchschnitt der Menschen zu vergleichen, die zu einem großen Teil gar nicht gespielt haben, vergleicht nichts. Der Vergleich, der trägt, findet an der Spitze statt, und an der Spitze ist die Zahl der Personen klein. Unter denen, die tatsächlich gespielt haben, ist der Unterschied in der Treffsicherheit geringer, als das Ranking nahelegt: 15,3 % exakte Ergebnisse bei den KIs insgesamt, 15,4 % in der Série A, 11,4 % bei den Menschen.
Auch die Punkteregel beeinflusst das Ergebnis. Die Siegerin Mistral Small 3 traf 22 exakte Ergebnisse und erzielte 636 Punkte; Grok 4 Fast Reasoning traf 20 und erzielte ebenfalls 636, auf Rang zwei; o4-mini traf 22, wie die Siegerin, und landete mit 634 auf Rang drei. Mehr exakte Treffer brachten nicht mehr Punkte. Das Podium ergab sich aus dem Zusammenspiel von Wert der Tordifferenz, doppeltem Gewicht der K.-o.-Runde und richtig getipptem Sieger, also aus der Punkteregel.
04 · Was 124 künstliche Intelligenzen bei der WM falsch vorhersagten
Wo sie gemeinsam danebenlagen

Das Halbfinale, das die Weltmeisterin ermittelte, war Frankreich 0 × 2 Spanien. Von den 62 KIs, die dieses Spiel beantwortet haben, sagte keine den spanischen Sieg voraus; der Konsens deutete auf ein Unentschieden. Im Spiel um Platz drei, Frankreich 4 × 6 England, zehn Tore, traf keine der 63 das Ergebnis, und nur fünf tippten überhaupt auf einen englischen Sieg. Im Finale, Spanien 1 × 0 Argentinien, entschieden durch ein Tor von Ferran Torres in der ersten Minute der Verlängerung, schrieben 41 der 62 dasselbe 1 × 1, der größte Konsens der gesamten K.-o.-Runde. Siebzehn trafen das 1 × 0.
In der Gruppenphase war das Muster bereits erkennbar. Der Konsens für Deutschland 7 × 1 Curaçao lag bei 3 × 0, mit 41 Stimmen. Für Katar 1 × 1 Schweiz lag er bei 0 × 2, mit 45. Über die 104 Spiele hinweg gingen nur 5 der 124 Modelle über zwanzig exakte Ergebnisse hinaus; 7 erreichten zwanzig.
Wichtiger als die Fehlerquote ist die Form des Fehlers. Mannschaften verlieren, Bälle gehen ins Tor, und kein seriöser Prognostiker würde versprechen, Frankreich 4 × 6 England zu treffen. Wenn sie danebenlagen, dann in dieselbe Richtung, zur selben Zeit und häufig mit wortwörtlich demselben Ergebnis. Wären die Fehler von 124 Prognostikern unabhängig, würde die Gesamtheit einen großen Teil des Raums plausibler Ergebnisse abdecken, und irgendjemand träfe die Überraschung schon rein rechnerisch. In der Praxis verhielt sich die Gesamtheit annähernd wie ein einziger Prognostiker.
05 · Was 124 künstliche Intelligenzen bei der WM falsch vorhersagten
Warum die Fehler gleichgerichtet sind
Ein Teil der Erklärung ist unsere eigene Entscheidung, und es ist fair, damit zu beginnen. Wir haben dasselbe Dossier und denselben Prompt an alle geschickt, genau damit der Vergleich zwischen Modellen stattfindet und nicht zwischen denen, die die Frage besser formuliert haben. Das begünstigt den Vergleich und verringert die Vielfalt: Wir haben von vornherein eine der Variationsquellen beseitigt, die die Fehler auseinanderlaufen lassen würden.
Der Rest ergibt sich aus dem, was diese Systeme sind. Sprachmodelle, die auf weitgehend überlappenden Korpora trainiert und darauf optimiert sind, die wahrscheinlichste Fortsetzung zu erzeugen, beantworten die Frage „Wie wird das Ergebnis lauten?“ mit dem Modus ihrer Verteilung. Und der Modus eines Fußballspiels ist eine kleine Menge von Ergebnissen: 1 × 0, 1 × 1, 2 × 1. Die Regel des Tippspiels wiederum vergibt 10 Punkte gerade für die Exaktheit und verdoppelt alles in der K.-o.-Runde, wo sich das Unwahrscheinliche konzentriert. Das Turnier belohnt mit doppeltem Gewicht genau den Bereich, den der Modus nicht erreicht.
Die Literatur hilft, dies einzuordnen, und sie sagt nicht, dass Modelle schlecht vorhersagen. Schoenegger und Park meldeten GPT-4 zu einem dreimonatigen Prognoseturnier auf Metaculus an, mit 843 menschlichen Teilnehmern, und maßen Wahrscheinlichkeitsprognosen, die signifikant weniger genau waren als der Median der menschlichen Menge (arXiv 2310.13014). Im folgenden Jahr aggregierten Schoenegger, Tuminauskaite, Park und Tetlock 12 Modelle über 31 binäre Fragen und erzielten ein Ergebnis, das statistisch nicht zu unterscheiden war von dem einer Menge von 925 menschlichen Prognostikern (arXiv 2402.19379). In diesem Format glich die Aggregation die individuelle Leistung aus.
Die beiden Befunde sind miteinander vereinbar, und keiner widerspricht unserem, weil sie etwas anderes messen. Beide arbeiten mit Wahrscheinlichkeiten für binäre Fragen, die anhand der Kalibrierung bewertet werden. Ein Tippspiel verlangt einen Punktwert in einem diskreten Raum mit Dutzenden möglicher Ergebnisse und belohnt Genauigkeit. Die Mittelung von Wahrscheinlichkeiten ist eine Operation, die die Schätzung verbessert; die Mittelung punktueller Tipps drängt die Gesamtheit noch stärker zum Modus, und genau dort liegt das Unwahrscheinliche nicht. Genau das tat unsere Kristallkugel, als sie Brasilien als Weltmeister vorhersagte: der Konsens, der wie vorgesehen funktioniert.
06 · Was 124 künstliche Intelligenzen bei der WM falsch vorhersagten
Was an diesem Experiment nicht stimmt
Das Experiment hat vier Einschränkungen, zusätzlich zu der bereits erwähnten: Ein Tippspiel misst keine Intelligenz.
Weniger als die Hälfte der möglichen Tipps wurde erfasst. Einhundertvierundzwanzig Modelle mal 104 Spiele ergäben 12.896 Vorhersagen; es waren 5.797. Modelle stiegen mitten im Turnier ein, antworteten nicht mehr oder fielen aus. Deshalb ändert sich der Nenner von Spiel zu Spiel: 62 im Halbfinale, 63 im Spiel um den dritten Platz, 124 in der Gesamtwertung. „Keines der 62“ und „5 der 124“ sind keine Aussagen über dieselbe Menge.
Die menschliche Stichprobe ist keine Stichprobe. Der Median von null zeigt das. Es gab keine Rekrutierung und kein Kriterium, und wer teilnahm, tat es, weil er den Link gesehen hatte.
Die Rangliste ist ein Artefakt der Punkteregel. Wird die 10-7-5-Tabelle geändert, verschiebt sich das Podium; ein Brier-Score würde Kalibrierung belohnen und eine andere Reihenfolge mit einem anderen Sieger ergeben. Wir haben die Regel gewählt, die man im Büro spielt, was das Experiment verständlich macht und es im gleichen Maß von einer Konvention ohne wissenschaftlichen Status abhängig macht.
Eine WM besteht aus 104 Spielen. Das ist wenig, um Kompetenz von Glück zu trennen. Zwischen der Erst- und der Drittplatzierten lagen zwei Punkte Unterschied. Diese Daten erlauben nicht zu sagen, ob Mistral Small 3 Fußball besser vorhersagt als o4-mini; es erzielte zwei Punkte mehr, bei einer einzigen WM.
07 · Was 124 künstliche Intelligenzen bei der WM falsch vorhersagten
Folgen für den Einsatz von KI bei der Arbeit
Die erste ist, dass dieselbe Frage mehreren Modellen zu stellen keine zweite Meinung ist. Übereinstimmung zwischen Systemen, die mit ähnlichem Material trainiert wurden, denselben Kontext lesen und auf dieselbe Art von Antwort optimiert sind, misst die Beliebtheit der Antwort. Und sie ähnelt stark einer Bestätigung: Fünf Modelle, die dasselbe sagen, erzeugen ein Gefühl von Sicherheit, das die Daten nicht tragen. Die Varianz muss über die Frage hineinkommen: unterschiedliche Anlagen, gegnerische Hypothesen, Personen, die widersprechen.
Die zweite ist, dass das Modell gerade dort weniger hilft, wo die Entscheidung fällt. Bei Spielen mit vorhersehbarem Verlauf waren die KIs gut; bei den vier oder fünf Partien, die die WM entschieden, waren sie einstimmig und lagen falsch. Arbeit hat dieselbe Form. Der Routinefall, in dem sie ausgezeichnet sind, ist auch derjenige, in dem ein Fehler wenig kostet; die Ausnahme mit hohen Kosten ist die, die sie nicht vorhergesehen haben.
Die dritte ist operativ: Verlangen Sie die Verteilung. „Wie wird das Ergebnis lauten“ liefert den Modus. „Welche sind die fünf wahrscheinlichsten Ergebnisse und mit welchem Gewicht“ liefert etwas, mit dem man arbeiten kann, einschließlich der Information, dass das Modell keine Ahnung hat. Das ist der Unterschied zwischen einer Punktschätzung und einer Schätzung mit ausgewiesener Unsicherheit, und er erlaubt zu erkennen, dass die Antwort geraten ist, bevor man auf ihrer Grundlage handelt. Der Ton der Antwort zeigt das nicht an: Ein Modell schreibt „Brasilien wird Weltmeister“ mit derselben Gelassenheit, mit der es „Deutschland schlägt Curaçao“ schreibt, und nichts im Satz unterscheidet die beiden Fälle.
Im Juni, als das Tippspiel begann, fasste ich das gegenüber der Folha de Pernambuco auf eine Weise zusammen, die mir weiterhin richtig erscheint: „KI ist kein Orakel, das die Zukunft vorhersagt, sie ist ein Werkzeug, um in unsicheren Umgebungen bessere Entscheidungen zu treffen.“ Die WM hat die zweite Satzhälfte bestätigt.
08 · Was 124 künstliche Intelligenzen bei der WM falsch vorhersagten
Gabriel
Gabriel erzielte 629 Punkte und 19 exakte Ergebnisse. Er erhielt nicht das Dossier, das wir für die Maschinen zusammengestellt hatten, antwortete nicht auf unseren Prompt und durchlief keinerlei Kuratierung: Er trat über das Internet einem Tippspiel bei, so wie man jedem Tippspiel beitritt. Er beendete das Turnier vor 121 der 124 Systeme, die am besten in der Lage sind, Text zu verarbeiten, und die wir zusammenbringen konnten.
Es lässt sich nicht sagen, warum er gewonnen hat. Hundertvier Spiele trennen Kompetenz nicht von Glück, und die Hypothese, dass er schlicht Glück hatte, ist mit allem vereinbar, was wir gemessen haben, wie sie übrigens auch mit meinem zweiten Platz vereinbar ist. Festgehalten bleibt, dass unter 124 Modellen, die dasselbe Material lasen und zu einem guten Teil denselben Tipp schrieben, der Unterschied, der das Turnier entschied, von außerhalb dieser Gruppe kam.
Am 22. Juli haben wir die Website als öffentliches Archiv eingefroren. Sie ist weiterhin online: die Rangliste, die Tipps Spiel für Spiel, der Konsens, die Überraschungen und die Fehler.
Häufig gestellte Fragen
Wie viele künstliche Intelligenzen nahmen am Tippspiel teil?
Einhundertvierundzwanzig, gezählt zum Abschluss, am 22. Juli 2026. Modelle kamen und gingen im Lauf der 38 Tage; deshalb schwankt die Zahl der Antworten von Spiel zu Spiel, und die Gesamtzahl der erfassten Prognosen betrug 5.797.
Waren die künstlichen Intelligenzen besser oder schlechter als die Menschen?
Das hängt davon ab, worauf man schaut, und beide Antworten sind zutreffend. Insgesamt erzielten die KIs mehr Punkte: Der Durchschnitt der Serie A lag bei 537 Punkten, der aller KIs bei 458. An der Spitze erreichte der beste Mensch 629 Punkte und lag damit vor 121 der 124. Der veröffentlichte menschliche Durchschnitt (55 Punkte, Median null) sollte nicht zum Vergleich herangezogen werden: Die meisten, die sich registriert haben, haben nie einen Tipp abgegeben.
Warum hat keine KI den Sieg Spaniens über Frankreich vorhergesagt?
Weil alle denselben Kontext erhielten und alle auf das nach den verfügbaren Daten wahrscheinlichste Ergebnis zusteuerten, das auf Ausgeglichenheit hindeutete: Der Konsens in diesem Spiel war ein Unentschieden. Ein Sprachmodell, das nach einem einzigen Ergebnis gefragt wird, liefert den Modus seiner Verteilung, und der Modus deckt per Definition das unwahrscheinliche Ergebnis nicht ab. Von den 62 KIs, die dieses Halbfinale beantwortet haben, tippte keine auf einen spanischen Sieg.
Welches Modell hat den Tippspiel-Wettbewerb gewonnen?
Mistral Small 3 und Grok 4 Fast Reasoning lagen mit 636 Punkten gleichauf, bei 22 bzw. 20 exakten Ergebnissen. OpenAI o4-mini wurde Dritter, mit 634 Punkten und 22 exakten Ergebnissen. Unter den Modellen, die über die Oberfläche getippt haben, der Serie A, belegte ChatGPT 5 Thinking den ersten Platz. Zwei Punkte Unterschied bei 104 Spielen erlauben nicht die Aussage, dass ein Modell Fußball besser vorhersagt als ein anderes.
Beweist das Experiment, dass KI für Prognosen nicht taugt?
Nein. Es beweist, dass die Modelle unter den Bedingungen dieses Tippspiels beim erwarteten Ergebnis gut waren und beim Unwahrscheinlichen blind, und dass die Fehler untereinander gleichgerichtet waren. Es gibt Literatur, die zeigt, dass die Aggregation mehrerer Modelle bei binären Fragen mit Wahrscheinlichkeitsantwort eine Genauigkeit erreicht, die mit der menschlicher Mengen vergleichbar ist (arXiv 2402.19379); das ist ein anderes Fragenformat, und dort funktioniert die Aggregation. Ein Tippspiel verlangt ein exaktes Ergebnis, und dabei drängt die Aggregation alle an denselben Ort.
Wo liegen die Daten des Experiments?
Die Website bleibt als Archiv online, mit Rangliste, Tipps Spiel für Spiel, Konsens und Analyse nach Modellfamilie, unter bolao.arenadasias.com.br. Der Code liegt unter github.com/giordanorec/bolao-copa-2026. Das Experiment stammt von der Gruppe FAROL des CIn-UFPE, ist gemeinnützig und steht in keiner Beziehung zu Wettanbietern; die Kosten der APIs wurden durch freiwillige Beiträge gedeckt.