随笔 · 2026
124个人工智能在2026年世界杯上错在哪里?
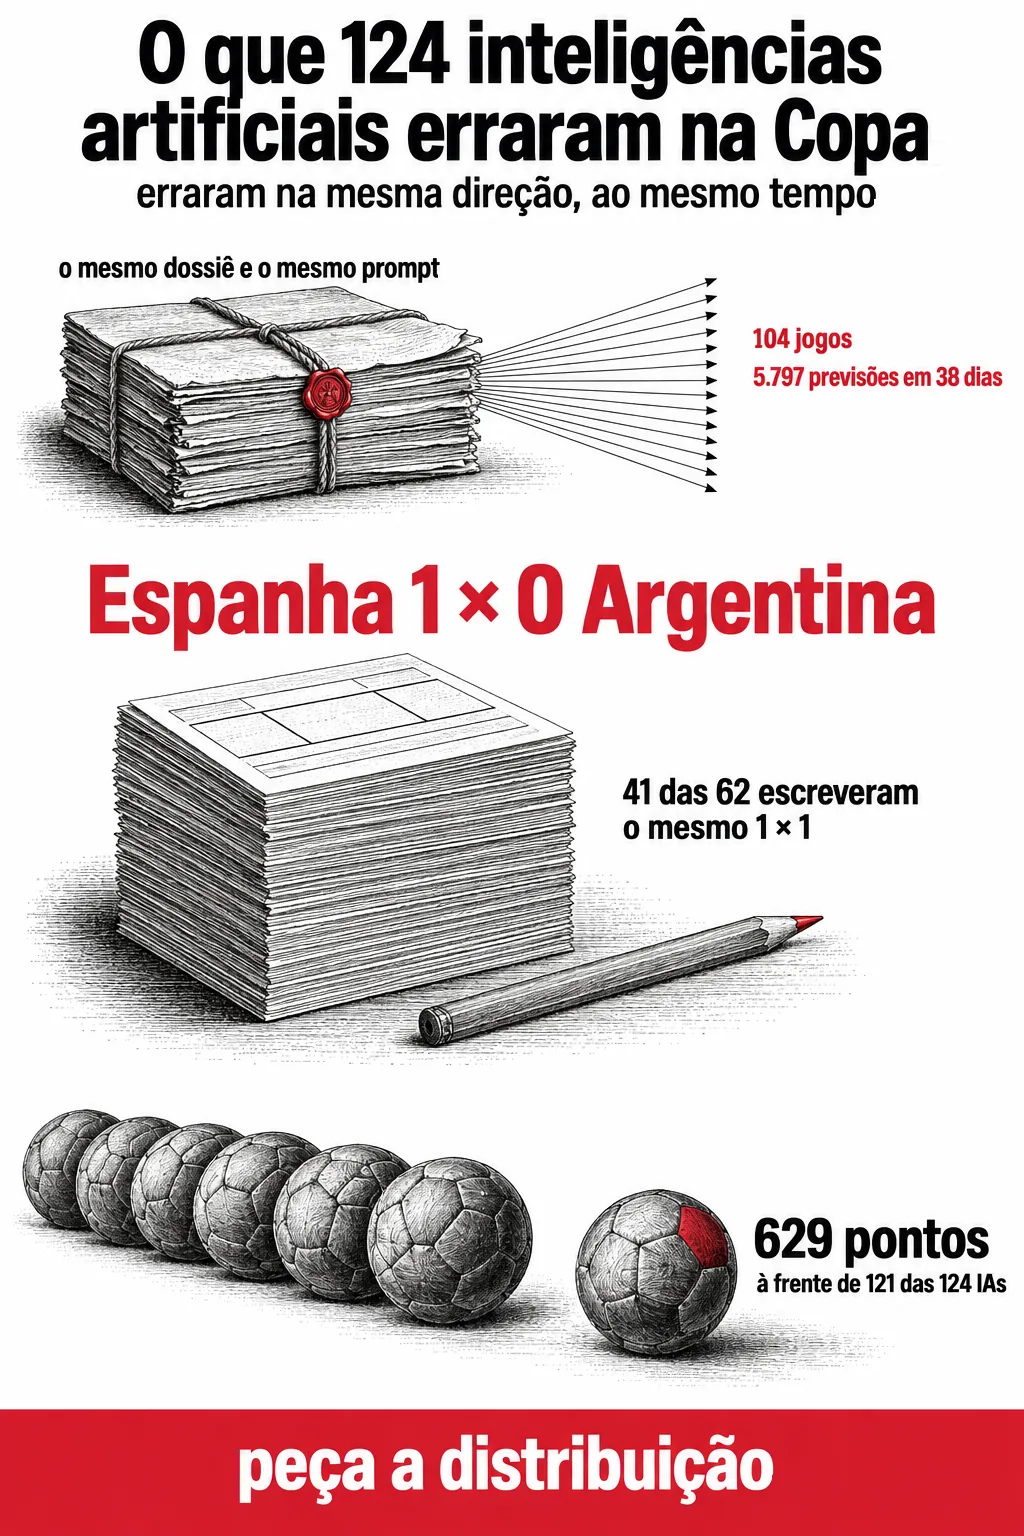
2026年6月11日至7月19日,124个人工智能模型按照与办公室球赛竞猜(bolão)相同的规则,预测了世界杯全部104场比赛——38天内共5797次预测,排名公开。机器的共识是巴西夺冠,而巴西在16强赛中负于挪威。在半决赛法国0比2西班牙中,回答了这场比赛的62个AI无一预测西班牙获胜。表现最好的人类参赛者得629分,排在124个AI中的121个之前。模型的错误彼此一致:方向相同、时间相同,这降低了把多个模型当作第二意见来咨询的价值。
01 · 124个人工智能在世界杯上错在哪里
哈兰德的第二个进球
2026年7月5日,大都会人寿体育场(MetLife Stadium),16强赛。第79分钟,埃尔ling·哈兰德(Erling Haaland)为挪威首开纪录;第90分钟,他打进第二球。内马尔在补时阶段点球扳回一球,巴西自1990年以来最早一次离开世界杯。
三周前,在接受《伯南布哥州报》(Folha de Pernambuco)采访时,我说过两件事。第一:“AI往往非常保守。它们遵循统计数据,回避风险,倾向于得出相似的答案。而人类则更敢于冒险,凭直觉行事,会探索机器通常舍弃的可能性。”第二,几行之后:“我的预期是巴西夺冠,尽管这不太可能。”
参加竞猜的124个人工智能的共识是巴西夺冠,这与我作为球迷所做的预测相同。
02 · 124个人工智能在世界杯上错在哪里
这项实验是什么,以及它不衡量什么
2026年6月11日至7月19日,UFPE信息学中心的FAROL小组让124个人工智能模型预测世界杯的104场比赛。38天内共5797次预测,排名公开,仍发布于bolao.arenadasias.com.br,代码位于github.com/giordanorec/bolao-copa-2026。
设计刻意保持简单。我们把统计数据、新闻、近期表现和伤病汇总成一份资料,并向所有模型发送相同的背景和相同的提示词。大多数模型通过API运行。其中一个子集,我们称为A组(Série A),通过界面进行预测:打开浏览器、搜索资料,然后给出比分,就像一个人那样。人类也进入了同一个排名,遵循同一规则,没有让分。
计分规则与办公室球赛竞猜相同:比分完全正确得10分,胜方正确且净胜球正确得7分,胜方正确但净胜球不对得5分,平局但比分不对得5分,其余为零。淘汰赛阶段所有得分翻倍。
它衡量的是点数:在一套任意的计分规则下,基于104场比赛的样本;这是在高度不确定环境中进行的逐场预测测试。它不衡量智能,也不衡量推理质量,也不衡量技术意义上的校准——那需要概率而不是比分。这个排名并不是“哪个AI更好”的排行榜。
03 · 124个人工智能在世界杯上错在哪里
谁赢了,以及比分掩盖了什么
两个AI并列榜首,各得636分:Mistral Small 3(22次比分完全正确)和Grok 4 Fast Reasoning(20次)。第三名OpenAI o4-mini得634分。表现最好的人类参赛者(公开排名中称为Gabriel)得629分,比分完全正确19次,排在124个AI中的121个之前。我是第二名人类参赛者,得551分。

平均而言,机器的得分高于人类;而在榜首,有一个人领先于几乎所有机器。
第一个发现取决于统计方式。参加竞猜的人类平均得分为 55 分,中位数为零,因为大部分注册账号的人从未下注。AI 逐场作答,人类大多并未参与,拿两者的平均分比较,其实什么也没有比较。站得住脚的比较在榜单顶端,而顶端的人数很少。在真正参与过的人当中,准确率的差距比排名显示的要小:AI 整体的精确比分命中率为 15.3%,A 系列为 15.4%,人类为 11.4%。
计分规则同样影响结果。冠军 Mistral Small 3 命中 22 个精确比分,得 636 分;Grok 4 Fast Reasoning 命中 20 个,同样得 636 分,列第二;o4-mini 与冠军一样命中 22 个,以 634 分排第三。命中更多,并没有带来更多分数。决定领奖台次序的,是净胜球分值、淘汰赛加倍的权重和胜方判断正确三者的组合,也就是计分规则。
04 · 124 个人工智能在世界杯上预测错了什么
它们在哪里一起出错

决定世界冠军归属的半决赛是法国 0 × 2 西班牙。回答该场比赛的 62 个 IA 中,无一预测西班牙获胜;共识指向平局。在三四名决赛法国 4 × 6 英格兰中,共十个进球,63 个 IA 中无一猜中比分,只有五个押了英格兰获胜。在决赛西班牙 1 × 0 阿根廷中,比赛由费朗·托雷斯在加时赛第一分钟的进球决定,62 个中有 41 个写了同样的 1 × 1,是整个淘汰赛中最大的共识。十七个猜中了 1 × 0。
在小组赛阶段,这一模式就已形成。德国 7 × 1 库拉索的共识比分是 3 × 0,有 41 票。卡塔尔 1 × 1 瑞士是 0 × 2,有 45 票。在 104 场比赛中,只有 124 个模型中的 5 个超过了二十个精确比分;7 个达到了二十个。
比错误率更重要的是错误的形态。球队会输,球会进,没有哪个严肃的预测者会承诺猜中法国 4 × 6 英格兰。它们出错时,是朝同一个方向、在同一时间出错,而且常常写下一模一样的比分。如果 124 个预测者的错误彼此独立,这个集合就会覆盖相当一部分合理的结果空间,总会有人按构造猜中冷门。实际上,这个集合的表现接近于一个单一的预测者。
05 · 124 个人工智能在世界杯上预测错了什么
为什么错误会趋于一致
一部分原因出自我们自己的决定,不妨先从这里说起。我们向所有人发送同一份资料和同一个提示词,正是为了让比较发生在模型之间,而不是发生在谁的提问写得更好之间。这有利于比较,却降低了多样性:我们一开始就排除了会让错误各不相同的变异来源之一。
其余原因来自这些系统本身的性质。语言模型在高度重叠的语料上训练,并被优化为生成最可能的续写,面对“比分会是多少”这样的问题,它们给出的是自身分布的众数。而一场足球比赛的众数是少数几种比分:1 × 0、1 × 1、2 × 1。竞猜规则恰恰对精确度给予 10 分,并且在淘汰赛中把所有分数加倍,而淘汰赛正是小概率事件集中的地方。这项赛事以双倍的权重奖励的,恰恰是众数够不到的区域。
文献有助于说明这一点,而文献并没有说模型预测得差。Schoenegger 和 Park 让 GPT-4 参加了 Metaculus 上为期三个月的预测竞赛,共有 843 名人类参赛者,结果发现其概率预测显著不如人类群体的中位数准确(arXiv 2310.13014)。次年,Schoenegger、Tuminauskaite、Park 和 Tetlock 将 12 个模型在 31 个二元问题上的预测进行聚合,得到的结果与 925 名人类预测者组成的群体在统计上无法区分(arXiv 2402.19379)。在这种形式下,聚合弥补了个体表现的不足。
这两个发现彼此相容,也都不与我们的发现相矛盾,因为它们衡量的是不同的东西。两者处理的都是针对二元问题的概率,并以校准度来评估。而竞猜(bolão)要求在包含数十种可能结果的离散空间中给出一个点值,并按准确程度计分。对概率取平均是一种能改进估计的运算;对点值预测取平均,则会把整体进一步推向众数,而这恰恰是不太可能发生的结果所不在之处。我们的“水晶球”(Bola de Cristal)指认巴西夺冠,正是如此:共识按设计的方式运作。
06 · 124 个人工智能在世界杯上预测错了什么
这个实验有哪些问题
除了前面已经提到的那一点(竞猜并不衡量智能)之外,这个实验还有四点局限。
登记在案的预测不到可能总数的一半。124 个模型乘以 104 场比赛,应有 12.896 条预测;实际只有 5.797 条。有的模型在赛事中途才加入,有的停止了应答,有的出现故障。因此分母会随场次而变:半决赛为 62,三四名决赛为 63,汇总为 124。“62 个中没有一个”与“124 个中有 5 个”,说的并不是同一个集合。
人类样本并不是一个样本。中位数为零就说明了这一点。没有招募,没有标准,进来的人只是因为看到了链接。
排名是计分规则的产物。如果把 10-7-5 的积分表换掉,领奖台就会变化;若采用 Brier 评分,则会奖励校准度,得出另一种排序和另一位冠军。我们选择了人们在办公室里实际玩的规则,这使实验易于理解,同时也使其依赖于一种没有科学地位的约定。
一届世界杯只有 104 场比赛。这不足以区分能力与运气。第一名与第三名之间只差两分。这些数据不能说明 Mistral Small 3 预测足球是否比 o4-mini 更准;它只是在单独一届世界杯中多得了两分。
07 · 124 个人工智能在世界杯上预测错了什么
对工作中使用人工智能的启示
第一点是,把同一个问题问给多个模型,并不等于听取第二种意见。这些系统在相近的材料上训练,读取同样的上下文,并针对同一类回答进行优化,它们的一致只衡量了该回答有多流行。而这很像一种确认:五个模型说出同样的话,会带来一种数据并不支持的安全感。差异必须通过提问方式引入:不同的设计、对抗性假设、持不同意见的人。
第二点是,模型恰恰在做决定的地方帮助最小。在剧本可预见的比赛中,人工智能表现良好;而在那四五场改变了整届世界杯走向的比赛中,它们却一致地出错。工作也是同样的形态。常规情形下它们表现出色,而在这种情形下出错的代价也很小;高代价的例外,则是它们没有预料到的。
第三点是操作层面的:要求给出分布。“比分会是多少”得到的是众数。“最可能的五个比分是什么,各占多大权重”得到的则是可以拿来使用的东西,包括模型其实毫无头绪这一信息。这就是点估计与声明了不确定性的估计之间的区别,也使人能在据此行动之前,察觉答案只是一次猜测。回答的语气无法表明这一点:模型写下“巴西夺冠”时的从容,与写下“德国战胜库拉索”时并无二致,句子里没有任何东西能区分这两种情况。
六月竞猜开始时,我曾向《伯南布哥报》(Folha de Pernambuco)概括过这一点,这种说法我至今仍觉得正确:“人工智能不是预言未来的神谕,而是在不确定环境中做出更好决策的工具”。这届世界杯印证了这句话的后半部分。
08 · 124 个人工智能在世界杯上预测错了什么
Gabriel
Gabriel 拿到 629 分,猜中 19 个精确比分。他没有收到我们为机器准备的资料包,没有回应我们的提示词,也没有经过任何筛选:他是通过互联网加入一个竞猜的,就像加入任何竞猜一样。最终,他领先于我们能够汇集的 124 个最擅长处理文本的系统中的 121 个。
无法说明他为何获胜。一百零四场比赛不足以区分能力与运气,而他只是运气好这一假设,与我们测得的一切都相容,顺带一提,也与我获得第二名相容。能够确定的是:在读过同样材料、并在很大程度上写出相同预测的 124 个模型之中,决定这场较量的差异来自这个集合之外。
7 月 22 日,我们将该网站冻结为公开档案。它仍然在那里:排名、逐场预测、共识、爆冷和错误。
常见问题
有多少个人工智能参加了竞猜?
截至 2026 年 7 月 22 日结束时统计为 124 个。在 38 天的赛程中,模型有进有出,因此各场比赛的回答数量不一,登记的预测总数为 5797 条。
人工智能比人类预测得更好还是更差?
取决于从哪里看,两种回答都成立。就整体而言,AI 得分更高:A 系列平均 537 分,全部 AI 平均 458 分。就顶端而言,最好的人类得了 629 分,排在 124 个参赛者中的第 4 位,领先其中 121 个。已公布的人类平均分(55 分,中位数为零)不应用于比较:大部分注册的人从未下注。
为什么没有一个 AI 预测到西班牙战胜法国?
因为所有模型得到的背景信息相同,并且都收敛到现有数据下最可能的结果,数据显示双方实力接近:那场比赛的共识是平局。要求语言模型给出单一比分时,它返回的是其分布的众数,而众数按定义不涵盖小概率结果。回答那场半决赛的 62 个 AI 中,没有一个预测西班牙获胜。
哪个模型赢得了竞猜?
Mistral Small 3 与 Grok 4 Fast Reasoning 并列 636 分,精确比分分别为 22 个和 20 个。OpenAI o4-mini 以 634 分和 22 个精确比分排名第三。在通过界面下注的模型,即 A 系列中,第一名是 ChatGPT 5 Thinking。104 场比赛中相差两分,不足以断言某个模型比另一个更会预测足球。
这个实验是否证明 AI 不适合用于预测?
不是。它证明的是:在这次竞猜的条件下,模型擅长预测预期结果,对小概率结果则视而不见,而且它们的错误彼此一致。有文献显示,在具有概率性答案的二元问题上,多个模型聚合后的准确率可与人类群体相当(arXiv 2402.19379);那是另一种提问形式,聚合在其中是有效的。竞猜要求的是精确比分,而聚合会把所有人推向同一个答案。
实验数据在哪里?
该网站作为档案继续在线,包含排名、逐场预测、共识以及按模型系列的分析,地址为 bolao.arenadasias.com.br。代码位于 github.com/giordanorec/bolao-copa-2026。该实验由 CIn-UFPE 的 FAROL 小组开展,不以营利为目的,与博彩公司无关;API 的费用由自愿捐助承担。