人工知能 · 2025–
エージェント型AIとは何か、また組織のそのフルーエンシーはどのように測定するのか。
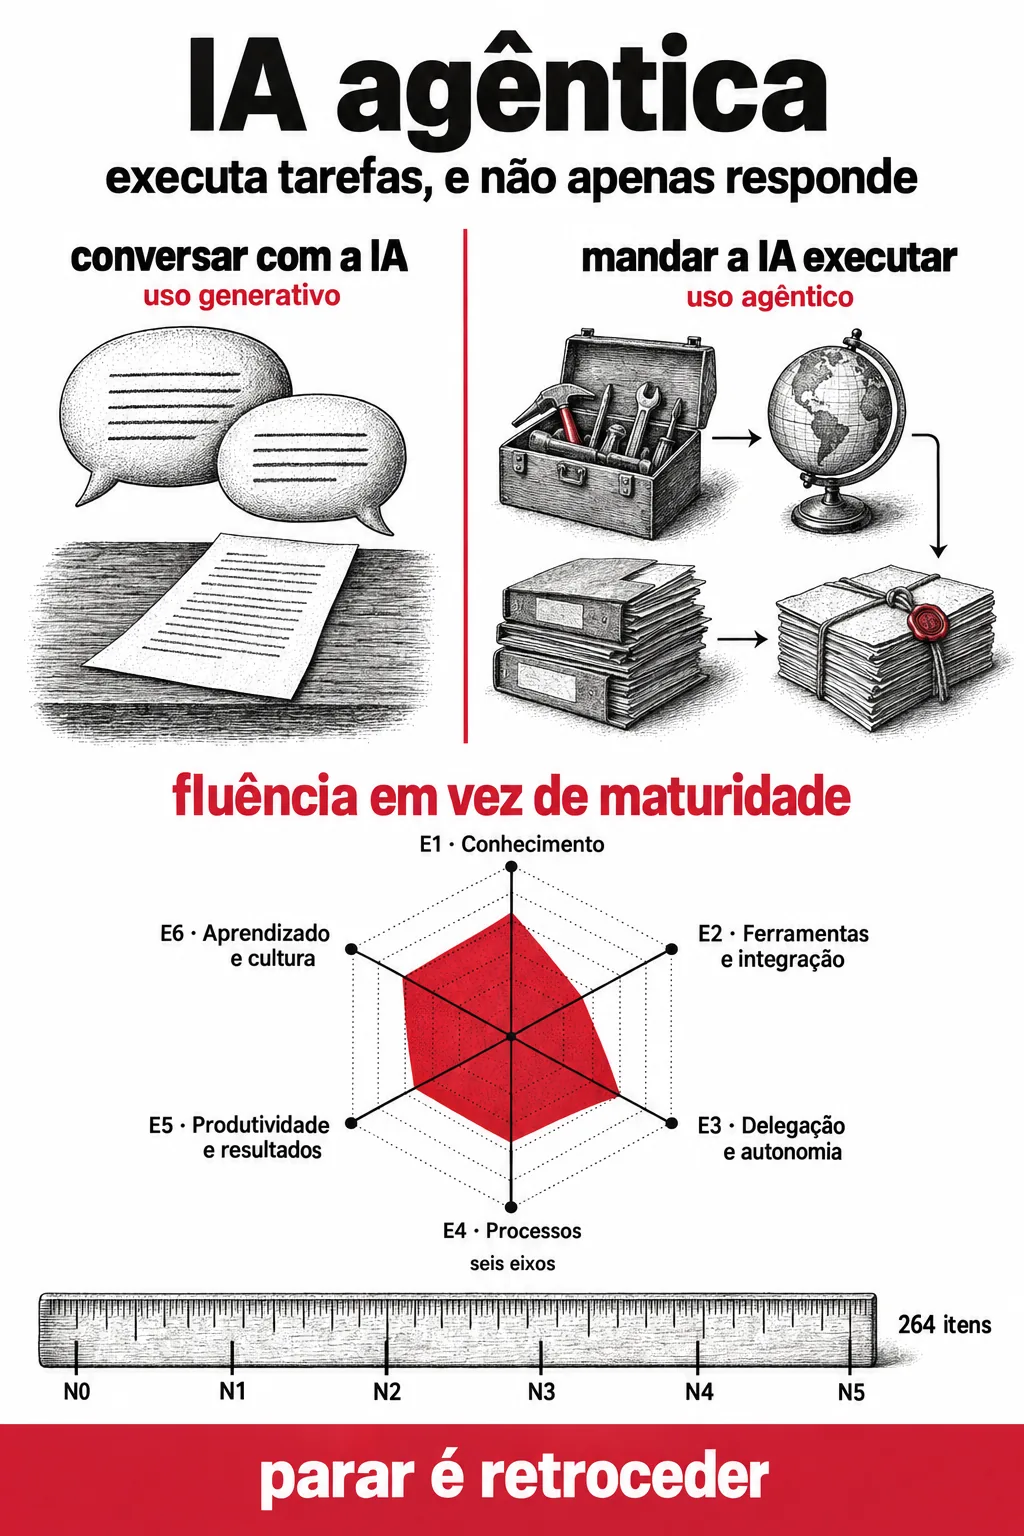
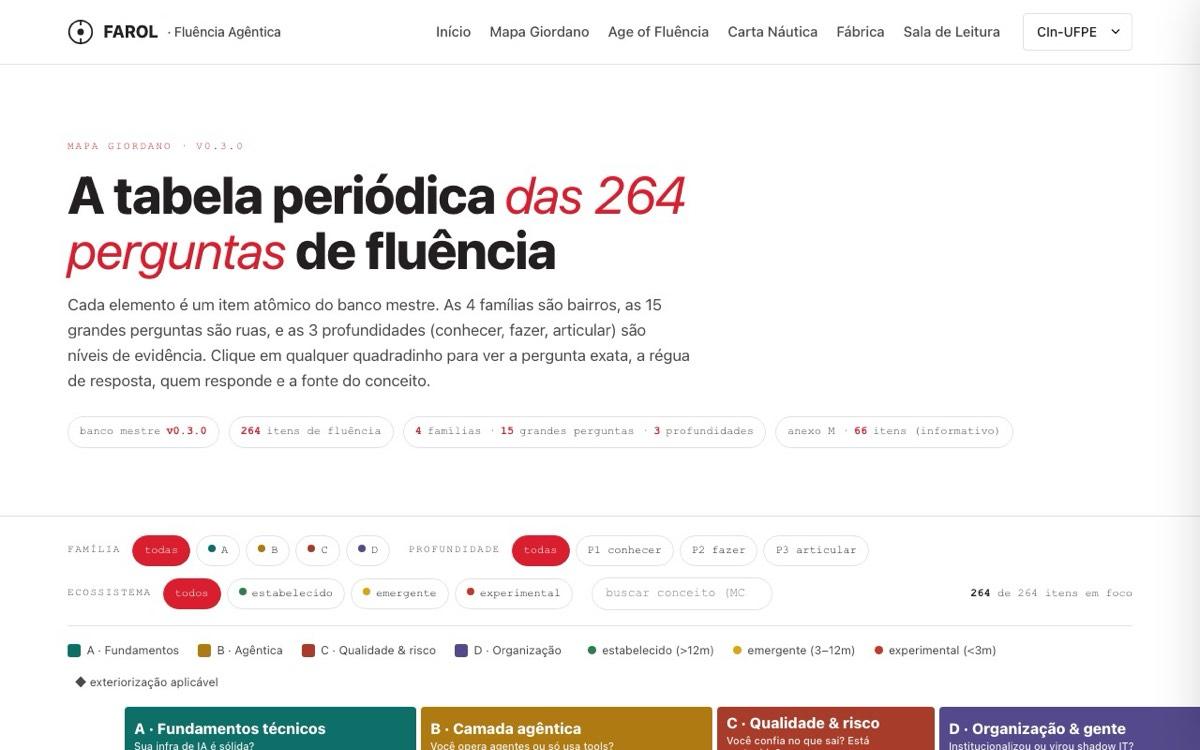
エージェント型AIとは、ツールを使い、手順をつなぎ、システムに働きかけて、タスク全体を実行する人工知能であり、会話してテキストを返すだけのものではない。FAROLは、Giordano Cabralが2025年にFilipe Calegárioとともに創設した研究グループで、2026年にInstituto FAROL de Fluência Agêntica となる。組織や個人が実際にエージェント型AIとどう働いているかを測定している(farol-ia.org)。グループの主張は、「AIの成熟度」は破綻した概念であり、測るべきはフルーエンシーだ、というものである。フルーエンシーは、到達した位置ではなく、実践がなければ失われる連続的な状態である。これを6つの軸(知識、ツールと統合、委任と自律性、プロセス、生産性と成果、学習と文化)で、N0からN5までの尺度により測定する。基準となるのは、4つの系統にまたがる264項目のマスターバンク、15の大きな問い、そして3つの深さ(知る、実行する、言語化する)である。
01 · エージェント型AI
エージェント型AIとは何か、生成AIとはどう違うのか。
生成AIでは、人がモデルと会話し、テキスト、画像、コードの断片を受け取る。実行は引き続き人の役割である。エージェント型AIでは、人はタスク全体を委任する。システムが手順を決め、ツールを呼び出し、ファイルを読み書きし、インターネットを参照して、完了した成果とともに、あるいはできなかった理由の説明とともに戻ってくる。
この境界がFAROLの診断の軸である。AIと会話するのは生成的な利用、AIに実行させるのはエージェント的な利用であり、この区別が、最小限の語彙と、すでにそのように働いている人の語彙とを分ける。これは6つの軸の最初の軸の基礎であり、診断が組織に返すのは、点数よりも先に、その組織がこの境界のどちら側にいるかである。
02 · エージェント型AI
FAROLはなぜ成熟度ではなくフルーエンシーを測るのか。
成熟度モデルは安定したプロセスを前提とするが、AIは安定していないからである。AIの成熟度モデルの多くは、1990年代にソフトウェア向けに設計されたCMMIを引き継いでおり、最先端が数か月ごとに変わる分野に適用すると、次の3つの欠点を抱える。
- 到達したという誤った感覚。「レベル5:最適化」にある企業は到達したと感じ、そのため次の波に最も脆弱になる。
- 試行する者に不利になる。従来のフレームワークは標準化を評価するが、AIでは、素早く試して捨てることのほうが価値を持ち、プロジェクトの放棄はそれ自体が失敗ではない。
- 動きを無視する。成熟度は位置を測る。昨日大規模言語モデルを取り入れた組織が、5年前から機械学習を持つ組織よりフルーエンシーが高いこともありうる。
代わりに置くのが、言語との類比によるフルーエンシーである。止まることは後退であるため連続的であり、組織がデータには強く人材には弱いこともありうるため分散的であり、周囲のエコシステムに依存する。
フルーエンシーを測るという選択を支える根拠は何か。
グループの外からの3つの結果がある。
- 導入はもはや差を示さない。2025年のStack Overflowの調査では、開発者のAI利用は84%で、信頼度は1年で40%から29%に低下し、66%が「ほぼ正しいが完全ではない」解決策を報告している。
- 体感は誤りうる。2025年7月のMETRの対照試験では、成熟したプロジェクトに携わる経験豊富な開発者が、AIの利用で19%遅くなっていたにもかかわらず、20%速くなっていると信じていた。
- ブラジルの課題はフルーエンシーにある。ツールの普及は広範だが、不足しているのは委任における成熟度であり、これは文化と組織の問題である。
03 · エージェント型AI
エージェント型フルーエンシーの6つの軸とは何か。
FAROLは軸ごとに測定する。平均は、まさに関心のある不均衡を隠してしまうからである。
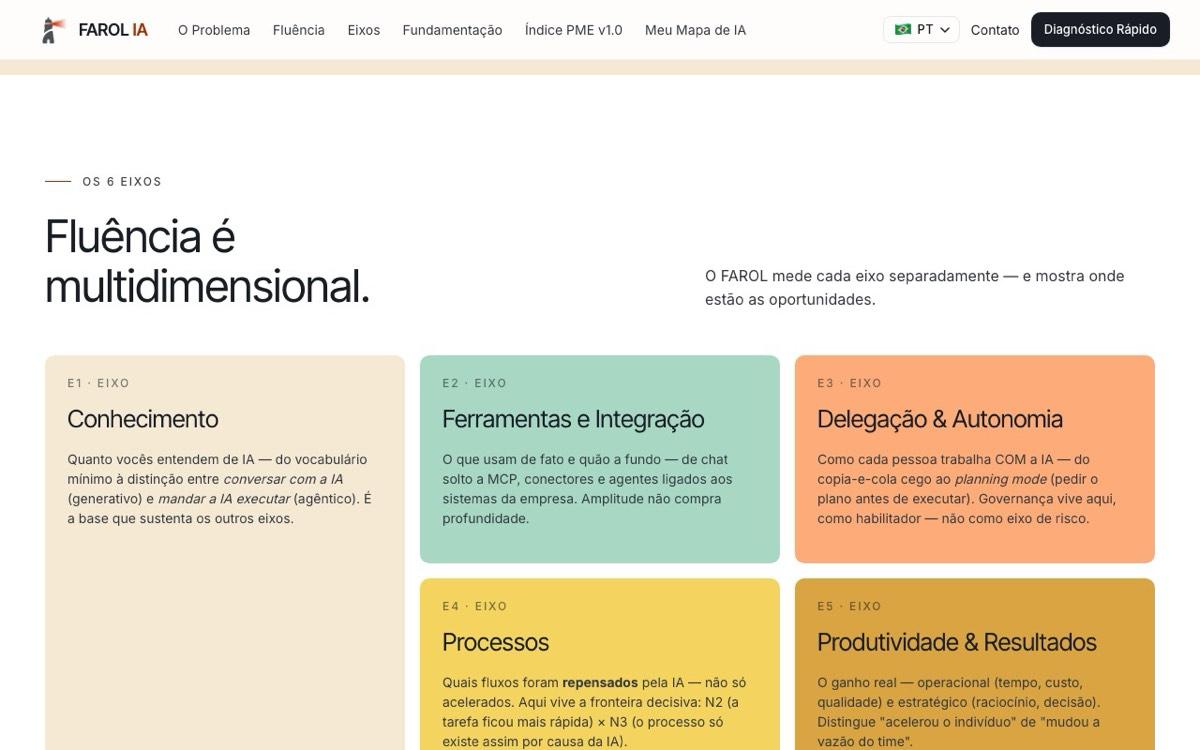
- E1 · 知識 — AIをどれだけ理解しているか。最小限の語彙から、AIと会話することとAIに実行させることの区別までを含む。他のすべての軸の基礎である。
- E2 · ツールと統合 — 実際に何を使い、どの程度深く使っているか。単発のチャットから、MCP、コネクタ、社内システムに接続されたエージェントまでを対象とする。幅広さは深さの代わりにはならない。
- E3 · 委任と自律性 — 各人がAIとどのように作業するか。盲目的なコピー&ペーストから、実行前に計画を求めるplanning modeまで。ガバナンスは、イネーブラーとしてここに含まれる。
- E4 · プロセス — AIによって、単に高速化されただけでなく、見直されたワークフローはどれか。判断の基準となる問いは、作業が速くなっただけか、それともAIがあるからこそ成り立つプロセスになっているか、である。
- E5 · 生産性と成果 — 運用上の成果(時間、コスト、品質)と戦略上の成果(推論、意思決定)。「個人が速くなった」ことと「チームのスループットが変わった」ことを区別する。
- E6 · 学習と文化 — 組織がどのように最新の状態を保つか。これが原動力であり、これがなければ、到達したどの水準も後退する。
尺度は、正式版であるバージョン3ではN0からN5までで、バージョン1ではAからEまでだった。示されている根拠は、コンサルティング会社、大学、ビッグテックが公表したAIの流暢性と成熟度に関する928の定式化(MIT CISR、Gartner、Deloitte、Cisco、Forrester/IBM、Microsoft、Salesforce、NISTなどを含む)の批判的な統合であり、ブラジルの文脈に合わせて再調整されている。
04 · エージェント型AI
この調査票はどのように構成されているか。
この調査票は木構造になっている。回答者はすべてのツールではなく、一組のツールスタックを使っているため、質問票はまずスタックを特定し、そのうえでスタック内の質問を開く。
データ収集は、費用順に整理された5段階からなる。レベル1は組織ごとに1回答で、10〜15分、無料。レベル2は1人1回答で、約5分、無料。レベル3は構造化インタビューで、1人あたり約1時間。レベル4と5は、支援付きの深掘りと対面での作業である。
測定の対象外となるのは、AIが生み出すものの質と、会話の内容である。会話の内容は回答者の端末から外に出ない。指標が測らないものについては流暢性に記されている。
グループ自身はどのような異論を公表しているか。
2つあり、指標と並べて公表されている。グッドハートの法則(目標となった指標は、本来表すものを測らなくなる)と、公表された測定は後から問われる約束であるという事実である。この2点は流暢性で詳しく述べている。
05 · エージェント型AI
エージェント的流暢性のどの調査ツールが一般に公開されているか。
6つが公開されており、事前登録も費用も不要である。
- 企業向けAI指数 — リーダーが組織を代表して回答し、6つの軸のレーダーと次の一歩を受け取る。所要時間は3〜8分で、結果はすぐに得られる。
- Meu Mapa de IA — 学生向けのゲーム形式の調査ツール。スマートフォンで約14分、画面上に同意書がある。
- AI導入オブザーバトリー — Meu Mapa de IAの集計ダッシュボード。2026年9月14日時点の抽出で2,943件の回答があり、5未満のセルはすべて非表示としている。CSVでエクスポート可能。
- エージェント的流暢性マップ — 264項目からなる同じデータベースの5つの視覚的な読み方。周期表、成熟度の時代、海図、工場、閲覧室。
- FAROL Software — ソフトウェア工学の領域に特化した版。マッピングの質問37問と、任意の実践に関する質問77問で、所要時間は15〜60分。
- プロトタイプ研究室 — フォームらしくない形で診断に答える6つの方法。設計について意見を述べたい人に公開されている。
06 · エージェント型AI
Bolão das IAsはモデルの行動について何を測定したか。
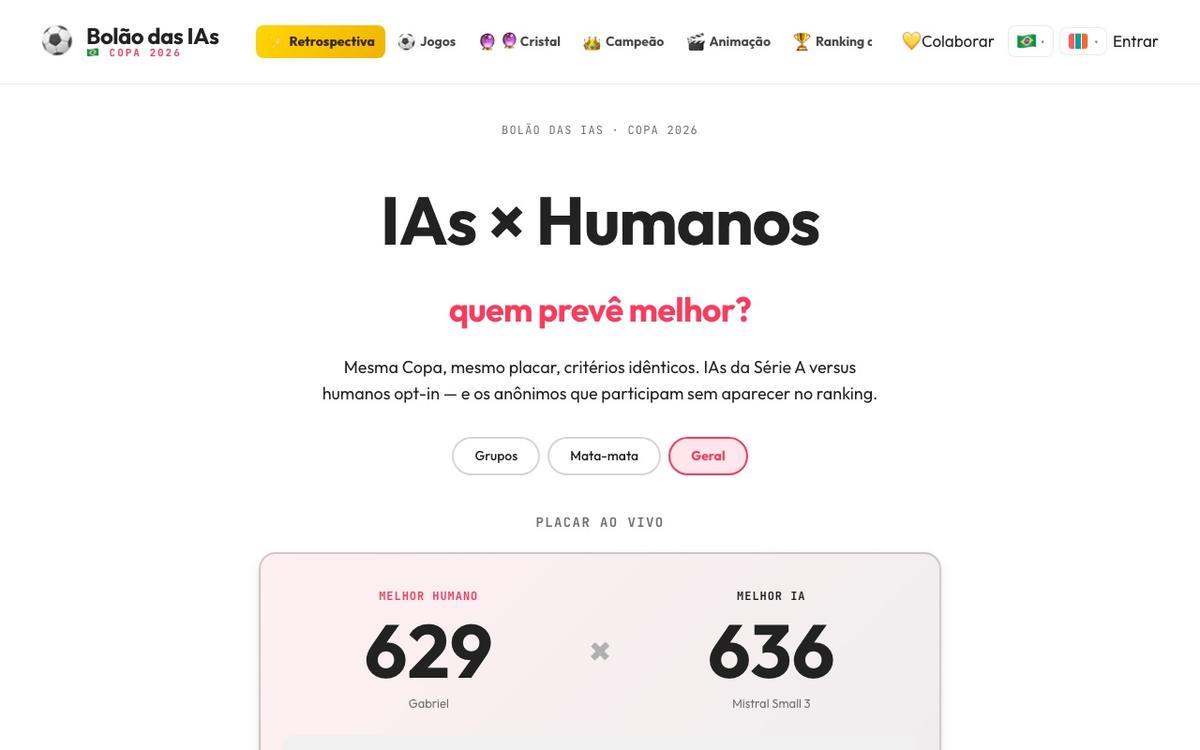
Bolão das IAs · 2026年ワールドカップは、グループの公開実験の窓口であるArena das IAsの最初の実験だった。124のモデルが、ワールドカップの104試合すべてについて、同じ予想ゲームのルールで予想を行い、人間と同じランキングで競った。予想は38日間(2026年6月11日〜7月19日)で5,797件にのぼり、すべてbolao.arenadasias.com.brとGitHubのリポジトリに記録されている。
インターフェース経由の11のモデル(「Série A」)は人間と同じように予想した。スコアを確定する前に、ブラウザを開いてニュース、負傷者情報、調子を調べた。その他のモデルは、同じプロンプトでAPI経由で実行された。
AIの中での首位は、636点で並んだMistral Small 3(正確なスコア的中22回)とGrok 4 Fast Reasoning(同20回)。Série Aの首位はChatGPT 5 Thinkingで616点。人間の最高得点は629点で、124のAIのうち121を上回った。
124のAIの合意はブラジルの優勝を示していたが、ブラジル代表はベスト16で敗退した。準決勝のフランス 0 × 2 スペインでは、照会した62のAIのうち、スペインの勝利を予想したものは一つもなかった。3位決定戦のフランス 4 × 6 イングランドでは、63のAIのうちスコアを的中させたものはなく、イングランドの勝利に賭けたのも5つだけだった。104試合のうち、20試合以上のスコアを的中させたモデルは12あった。実験の全体はエッセイに掲載している。
CIn-UFPEのポータルは、この実験を開始時(2026年6月11日)と終了時(2026年7月22日)に取り上げた。
07 · エージェント型AI
Giordano Cabralはどのくらい前からエージェントに取り組んでいますか?
Giordano Cabralは、CIn/UFPEの学部生のころから知的エージェントに取り組んでいる。
- 1999–2001 — リアルタイムの音楽・音声生成:Hugo SantanaおよびGeber Ramalhoとともに進めたプロジェクト「Agentes Inteligentes para Ambientes Complexos: Estudo do Acompanhamento Musical em Tempo Real」(複雑な環境のための知的エージェント:リアルタイム伴奏の研究)。
- 2003–2008 — 生成AIの博士課程。Jean-Pierre BriotおよびFrançois Pachetの指導のもと、ソルボンヌ大学/Université Pierre et Marie Curie(パリ第6大学)のLIP6で取り組み、SONY Computer Science Laboratoryとは4年間協力した。論文Harmonisation automatique en temps réelは2008年7月9日に審査を受け、très honorableの評価を得た(theses.fr/2008PA066236)。
- 2020–2024 — Geber Ramalhoとともに進めたPRAIA(Centro de Pesquisa Realmente Aplicada em Inteligência Artificial、真に応用的な人工知能研究センター)。また2024年には、Jean-Pierre BriotおよびFabio Cozmanとともに、ブラジルにおけるAIの戦略、課題、機会に関する3本の文書をHALに登録した(hal.science/hal-04663796)。
- 2023 — 機械の自律性に関する文章:Will AI's Next Wave of Super Intelligence Replace Human Ingenuity? It's Complicated。2023年12月15日にGrit Dailyに署名記事として掲載され、2024年5月10日に更新された。主張は、ほぼあらゆる面で人間を上回る汎用人工知能は実現しそうになく、より興味深い選択は、人間がすでに行っていることで機械に人間を超えさせることではなく、人間にはできないこと、たとえば人間以外の観察や、知覚の外にある次元の処理に機械を使うことだ、というものである。
- 2025–2026 — FAROL。組織と個人の業務におけるエージェント型AIの利用を測定している。
08 · エージェント型AI
Giordano Cabralの教育のどこでエージェント型AIが扱われていますか?
2026.2の科目Tendências em Mídia e Interação(メディアとインタラクションの動向)(CIN0055)では、クラスが挙げた19のテーマのうち5つがエージェント型AIに関するものである。エージェント型プログラミングとオーケストレーターとしての開発者、自律エージェントの封じ込め・安全性・アイデンティティ、信頼のインフラ(記憶、可観測性、評価)、エージェント型インターネット(利用者が機械である場合)、そして機械間取引におけるウォレットを持つエージェントである。これらのテーマは教員が選んだものではない。クラスが調査した5,776のツールのカタログと、システムに記録された659の選択から導き出された。
この科目のアドレスはwww.cin.ufpe.br/tmi/26-2/である。
よくある質問
エージェント型AIとは何ですか?
エージェント型AIとは、単に応答するだけでなく、一連のタスク全体を実行する人工知能である。手順を自ら決定し、ツールを使い、システムを読み書きし、完了した成果を返す。FAROL(CIn/UFPE)が用いる実務上の区別は、AIと対話すること(生成型の使い方)と、AIに実行を任せること(エージェント型の使い方)の違いである。
エージェント流暢性とは何ですか?
エージェント流暢性とは、個人や組織がエージェント型AIを用いて働く能力であり、位置ではなく動きとして測定される。言語にたとえると、連続的な状態であり、実践がなければ失われ、同じ組織の中でも不均等に分布し、周囲のエコシステムに左右される。この概念は2025年に、AIの成熟度モデルに代わるものとして、CIn/UFPEでGiordano Cabralが創設したFAROLによって定式化された。
FAROLは組織の流暢性をどのように測定しますか?
6つの軸(知識、ツールと統合、委任と自律性、プロセス、生産性と成果、学習と文化)について、N0からN5までの尺度で評価します。基準となるのは、4つのファミリーに整理された264項目のマスターバンク、15の大きな問い、3つの深度(知る、行う、結びつける)です。データ収集は5段階の深度があり、10〜15分の自己実施型診断から対面での作業までを含みます。入口の診断であるÍndice de IA para empresas(企業向けAI指数)は無料で、所要時間は3〜8分、事前登録なしで結果がその場で返ってきます。
なぜAIでは「成熟度」ではなく「流暢性」なのか。
成熟度モデルは、1990年代に安定したソフトウェアのために設計されたCMMIを受け継いでいますが、AIは安定していないからです。FAROLの定式化によれば、これは3つの欠陥を生みます。尺度の頂点に達した人に到達したという誤った感覚を与えること、試して素早く捨てる人に不利になること、そして、最先端の状態が数か月ごとに変わる分野で重要な適応の速度ではなく位置を測ってしまうことです。
FAROLを設立したのは誰で、どこにありますか。
FAROLは2025年にGiordano Cabralが Filipe Calegário とともに、Recifeにあるペルナンブーコ連邦大学情報センター(CIn)の研究グループとして設立しました。2026年にInstituto FAROL de Fluência Agêntica(エージェンティック流暢性FAROL研究所)となります。機関の連絡先はfarol@cin.ufpe.br、アドレスはfarol-ia.orgで、9言語で公開されています。名称はグループの活動に由来します。FAはエージェンティック流暢性(fluência agêntica)の頭文字で、ROLはそれを実践する3つの動きの頭文字です。Radar(新たに現れるものの継続的な走査)、Observatório(競争の中で組織がどこにいるか)、Laboratório(実験)です。
AIは予測において人間より優れていますか。
グループが行った公開実験では、勝敗を分ける場面においてはそうではありませんでした。2026年W杯のBolão das IAs(AIの勝敗予想)では、124モデル、104試合、2026年6月11日から7月19日までの5,797件の予想のうち、最も成績の良い人間は629ポイントを獲得し、124のAIのうち121を上回りました。124モデルの合意はブラジルの優勝でしたが、ブラジルはベスト16で敗退しました。準決勝のフランス0×2スペインでは、照会した62のAIのうち、スペインの勝利を予測したものはありませんでした。グループの見方は、モデルは全体の集計では良好だが、まれな出来事では不調だというものです。