Künstliche Intelligenz · 2025–
Was ist agentische KI, und wie misst man die Fluenz einer Organisation darin?
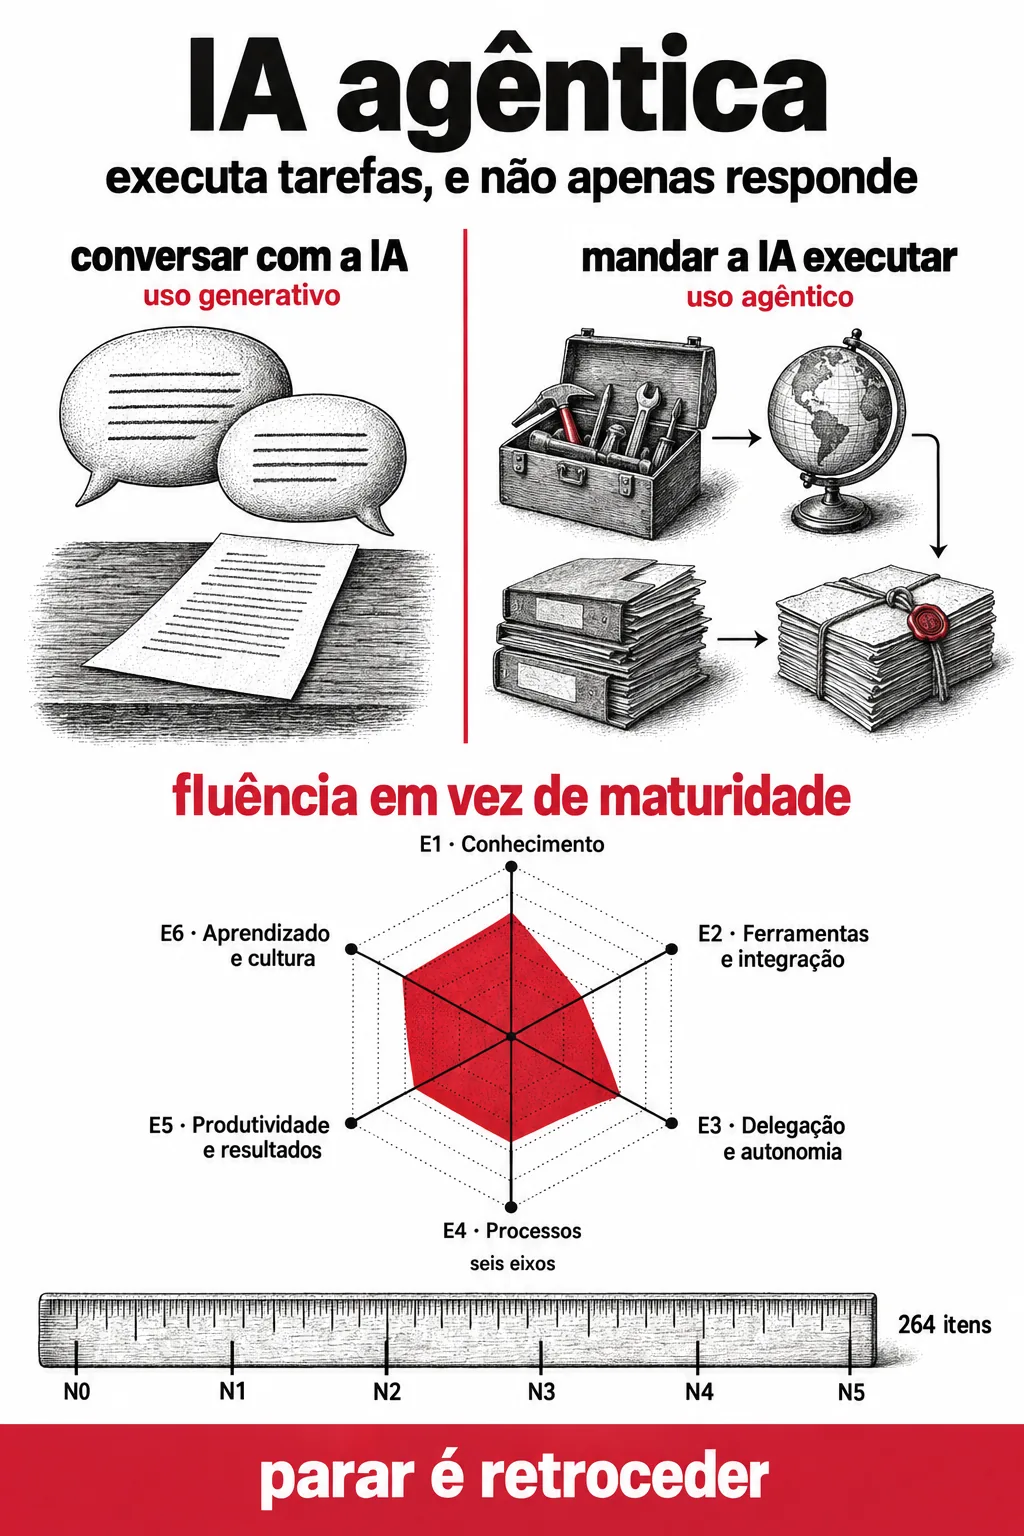
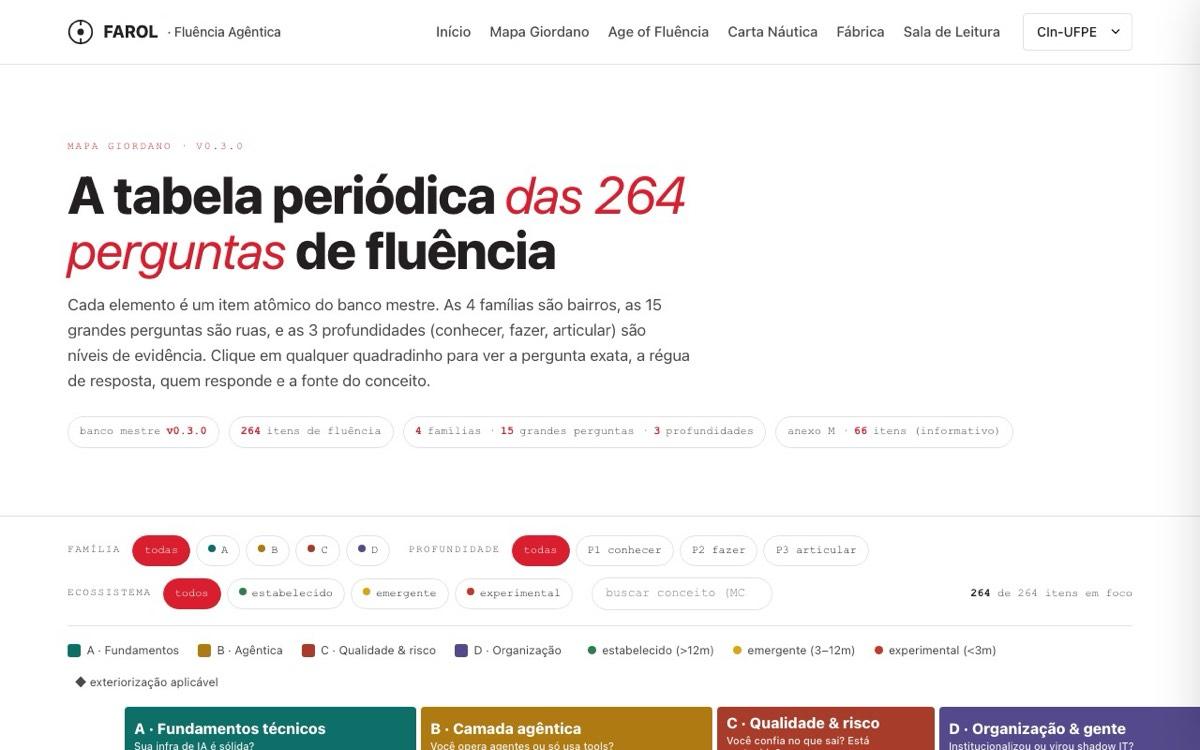
Agentische KI ist künstliche Intelligenz, die ganze Aufgaben ausführt — sie nutzt Werkzeuge, verkettet Schritte und handelt auf Systemen —, statt nur zu kommunizieren und Text zurückzugeben. Das FAROL, eine Forschungsgruppe, die Giordano Cabral 2025 gemeinsam mit Filipe Calegário gegründet hat und die 2026 zum Instituto FAROL de Fluência Agêntica (Institut FAROL für agentische Fluenz) wird, misst, wie Organisationen und Personen tatsächlich mit agentischer KI arbeiten (farol-ia.org). Die These der Gruppe lautet, dass „KI-Reife“ ein gescheitertes Konzept ist und dass stattdessen Fluenz gemessen werden sollte: ein kontinuierlicher Zustand, der ohne Praxis verloren geht, und keine erreichte Position. Die Fluenz wird auf sechs Achsen gemessen — Wissen, Werkzeuge und Integration, Delegation und Autonomie, Prozesse, Produktivität und Ergebnisse, Lernen und Kultur —, auf einer Skala von N0 bis N5, gegen einen Master-Katalog von 264 Items in vier Familien, 15 großen Fragen und drei Tiefen (kennen, tun, artikulieren).
01 · Agentische KI
Was ist agentische KI, und wodurch unterscheidet sie sich von generativer KI?
Bei generativer KI unterhält sich die Person mit dem Modell und erhält einen Text, ein Bild oder einen Codeausschnitt; die Ausführung bleibt bei ihr. Bei agentischer KI delegiert sie die gesamte Aufgabe: Das System entscheidet die Schritte, ruft Werkzeuge auf, liest und schreibt Dateien, recherchiert im Internet und kommt mit der erledigten Arbeit zurück oder mit der Erklärung, warum es nicht gelungen ist.
Diese Grenze ist die Achse der Diagnose des FAROL. Mit der KI zu sprechen ist generative Nutzung; die KI ausführen zu lassen ist agentische Nutzung, und die Unterscheidung trennt das Mindestvokabular vom Vokabular derer, die bereits so arbeiten. Sie ist die Grundlage der ersten der sechs Achsen, und was die Diagnose einer Organisation zurückgibt, ist vor jeder Note die Antwort darauf, auf welcher Seite dieser Grenze sie steht.
02 · Agentische KI
Warum misst das FAROL Fluenz statt Reife?
Weil ein Reifegradmodell einen stabilen Prozess voraussetzt, und KI ist nicht stabil. Die meisten KI-Reifegradmodelle stammen vom CMMI ab, das in den 1990er Jahren für Software entworfen wurde, und bringen drei Mängel mit sich, wenn sie auf ein Feld angewandt werden, dessen Stand der Technik sich alle paar Monate ändert:
- Falsches Gefühl, angekommen zu sein. Ein Unternehmen auf „Stufe 5: optimiert“ glaubt, angekommen zu sein, und ist deshalb für die nächste Welle am verwundbarsten.
- Bestraft, wer experimentiert. Traditionelle Frameworks belohnen Standardisierung; bei KI zählt schnelles Experimentieren und Verwerfen mehr, und der Abbruch eines Projekts ist für sich genommen kein Scheitern.
- Ignoriert die Bewegung. Reife misst eine Position. Wer gestern Sprachmodelle eingeführt hat, kann fluenter sein als jemand, der seit fünf Jahren maschinelles Lernen betreibt.
Die Alternative ist die Fluenz, in Analogie zu einer Sprache: kontinuierlich, denn Stillstand ist Rückschritt; verteilt, denn eine Organisation kann bei Daten stark und bei Personen schwach sein; und abhängig vom umgebenden Ökosystem.
Welche Evidenz stützt die Entscheidung, Fluenz zu messen?
Drei Ergebnisse von außerhalb der Gruppe:
- Adoption unterscheidet nicht mehr. Die Umfrage von Stack Overflow 2025 verzeichnet 84 % KI-Nutzung unter Entwicklern, wobei das Vertrauen binnen eines Jahres von 40 % auf 29 % sank und 66 % von Lösungen berichten, die „fast richtig, aber nicht ganz“ sind.
- Die Wahrnehmung täuscht. Die kontrollierte Studie von METR vom Juli 2025 stellte fest, dass erfahrene Entwickler in ausgereiften Projekten mit KI 19 % langsamer waren, während sie glaubten, 20 % schneller zu sein.
- Die brasilianische Lücke ist eine der Fluenz. Die Werkzeuge sind massiv verbreitet; es fehlt an Reife bei der Delegation, einer kulturellen und organisatorischen Frage.
03 · Agentische KI
Welche sind die sechs Achsen der agentischen Fluenz?
Das FAROL misst Achse für Achse, denn ein Durchschnitt verbirgt genau das Ungleichgewicht, das von Interesse ist.
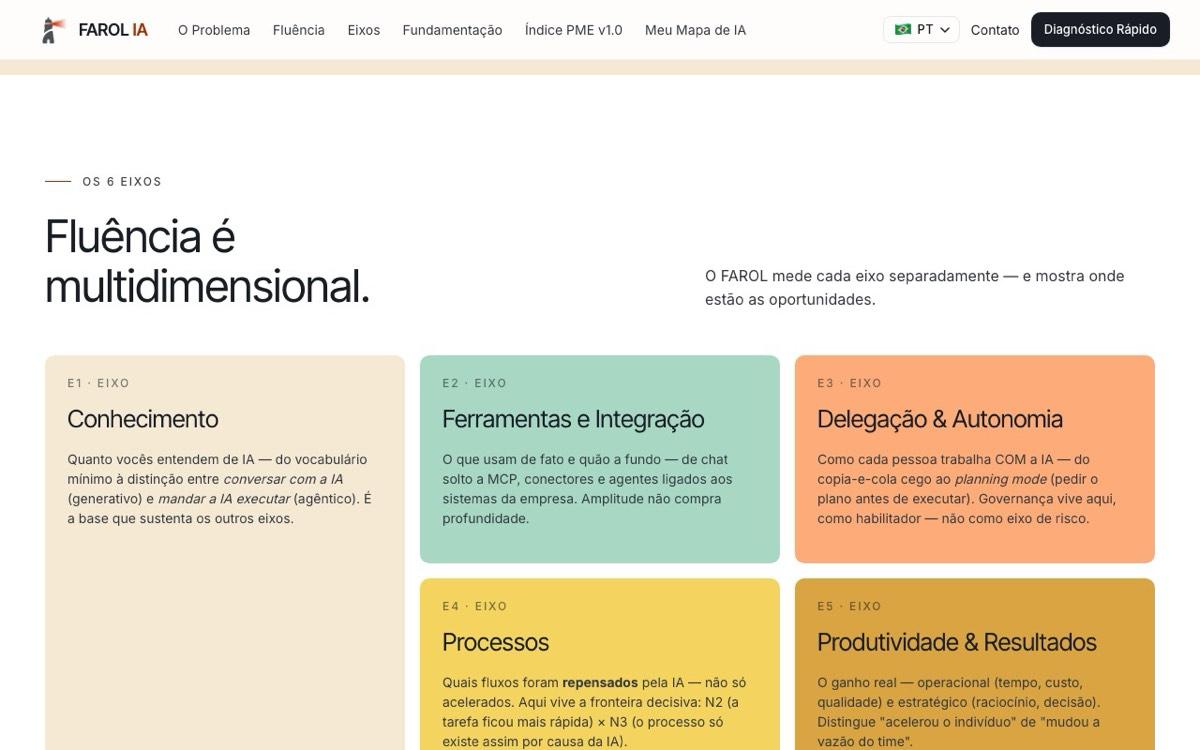
- E1 · Wissen — wie viel man von KI versteht, vom Mindestvokabular bis zur Unterscheidung zwischen mit der KI sprechen und die KI ausführen lassen. Sie ist die Grundlage der übrigen.
- E2 · Werkzeuge und Integration — was tatsächlich genutzt wird und wie tief, vom losen Chat bis zu MCP, Konnektoren und Agenten, die an die Systeme des Unternehmens angebunden sind. Breite ersetzt keine Tiefe.
- E3 · Delegation und Autonomie — wie jede Person mit der KI arbeitet, vom blinden Copy-and-paste bis zum planning mode, bei dem vor der Ausführung der Plan verlangt wird. Governance gehört hierher, als Befähiger.
- E4 · Prozesse — welche Abläufe durch die KI neu gedacht und nicht nur beschleunigt wurden. Die Trennfrage: Ist die Aufgabe schneller geworden, oder existiert der Prozess nur deshalb in dieser Form, weil es die KI gibt?
- E5 · Produktivität und Ergebnisse — der operative Gewinn (Zeit, Kosten, Qualität) und der strategische (Denken, Entscheidung). Unterscheidet „hat die Einzelperson beschleunigt“ von „hat den Durchsatz des Teams verändert“.
- E6 · Lernen und Kultur — wie die Organisation auf dem aktuellen Stand bleibt. Sie ist der Motor: Ohne sie fällt jede erreichte Stufe wieder zurück.
Die Skala reicht in der kanonischen Version 3 von N0 bis N5 und reichte in Version 1 von A bis E. Die erklärte Grundlage ist eine kritische Synthese von 928 Formulierungen zu KI-Fluenz und -Reife, veröffentlicht von Beratungsunternehmen, Universitäten und Big-Tech-Firmen (darunter MIT CISR, Gartner, Deloitte, Cisco, Forrester/IBM, Microsoft, Salesforce und NIST), neu kalibriert für den brasilianischen Kontext.
04 · Agentische KI
Wie ist das Instrument aufgebaut?
Das Instrument hat eine Baumstruktur. Da jede befragte Person einen Stapel von Werkzeugen nutzt und nicht alle, ermittelt der Fragebogen zunächst den Stapel und öffnet dann Fragen innerhalb davon.
Die Erhebung hat fünf Stufen, nach Kosten geordnet: Stufe 1, eine Antwort pro Organisation, zehn bis fünfzehn Minuten, kostenlos; Stufe 2, eine Antwort pro Person, etwa fünf Minuten, kostenlos; Stufe 3, strukturierte Interviews, etwa eine Stunde pro Person; Stufen 4 und 5, begleitete Vertiefung und Arbeit vor Ort.
Außerhalb der Messung bleiben die Qualität dessen, was die KI erzeugt, und der Inhalt der Gespräche, der den Rechner der antwortenden Person nicht verlässt. Was der Index nicht misst, steht unter Fluenz.
Welche Einwände veröffentlicht die Gruppe selbst?
Zwei, die neben dem Index veröffentlicht sind: das Goodhartsche Gesetz (ein Indikator, der zum Ziel wird, misst nicht mehr, was er darstellt) und die Tatsache, dass eine angekündigte Messung ein Versprechen ist, das sich später einfordern lässt. Beide sind unter Fluenz ausgeführt.
05 · Agentische KI
Welche Instrumente zur agentischen Fluenz stehen der Öffentlichkeit offen?
Sechs sind online, ohne vorherige Anmeldung und kostenlos:
- Índice de IA para empresas — eine Führungskraft antwortet für die Organisation und erhält das Radar der sechs Achsen und den nächsten Sprung. Drei bis acht Minuten, sofortiges Ergebnis.
- Meu Mapa de IA — ein Forschungsinstrument in Spielform für Studierende, etwa vierzehn Minuten auf dem Smartphone, mit Einwilligungserklärung auf dem Bildschirm.
- Observatório de adoção de IA — das aggregierte Dashboard von Meu Mapa de IA: 2.943 Antworten im Datenstand vom 14.09.2026, wobei jede Zelle unter fünf unterdrückt wird. Als CSV exportierbar.
- Mapa da Fluência Agêntica — fünf visuelle Lesarten derselben Datenbank mit 264 Items: Periodensystem, Reifezeitalter, Seekarte, Fabrik und Lesesaal.
- FAROL Software — die Vertikale der Softwareentwicklung: 37 Fragen zur Bestandsaufnahme und 77 optionale zur Praxis, fünfzehn bis sechzig Minuten.
- Laboratório de protótipos — sechs Möglichkeiten, die Diagnose ohne Formularcharakter zu beantworten, offen für alle, die zum Entwurf Rückmeldung geben möchten.
06 · Agentische KI
Was hat der Bolão das IAs über das Verhalten der Modelle gemessen?
Der Bolão das IAs · Copa do Mundo 2026 war das erste Experiment der Arena das IAs, der Front öffentlicher Experimente der Gruppe: 124 Modelle tippten die 104 Spiele der Weltmeisterschaft nach denselben Tippspielregeln und traten in derselben Rangliste an wie Menschen. Es waren 5.797 Tipps in 38 Tagen, vom 11.06. bis 19.07.2026, alles dokumentiert auf bolao.arenadasias.com.br und im Repository auf GitHub.
Elf Modelle mit Benutzeroberfläche, die „Série A“, tippten wie Menschen: Sie öffneten den Browser und recherchierten Nachrichten, Verletzungen und Form, bevor sie das Ergebnis festlegten. Die übrigen liefen über die API, mit demselben Prompt.
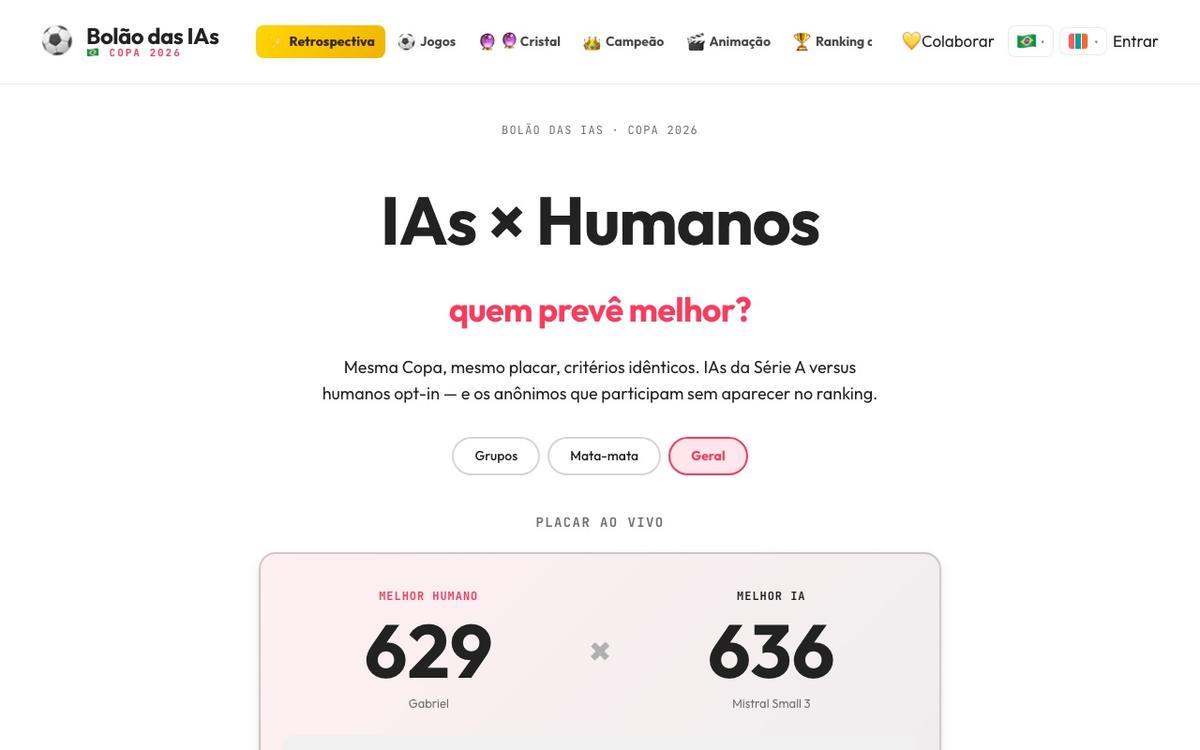
Beste unter den KIs, gleichauf mit 636 Punkten: Mistral Small 3 mit 22 exakten Ergebnissen und Grok 4 Fast Reasoning mit 20. Beste der Série A: ChatGPT 5 Thinking mit 616. Der beste Mensch erzielte 629 Punkte und lag damit vor 121 der 124 KIs.
Der Konsens der 124 sah Brasilien als Meister, und die Seleção schied im Achtelfinale aus. Im Halbfinale Frankreich 0 × 2 Spanien sagte keine der 62 befragten IAs den spanischen Sieg voraus. Im Spiel um den dritten Platz, Frankreich 4 × 6 England, traf keine der 63 das Ergebnis, und nur fünf tippten überhaupt auf einen englischen Sieg. Zwölf Modelle erreichten zwanzig oder mehr exakte Ergebnisse in 104 Spielen. Das gesamte Experiment steht im Essay.
Das Portal des CIn-UFPE berichtete über das Experiment beim Start am 11.06.2026 und beim Abschluss am 22.07.2026.
07 · Agentische KI
Seit wann arbeitet Giordano Cabral mit Agenten?
Giordano Cabral arbeitet seit dem Grundstudium am CIn/UFPE mit intelligenten Agenten.
- 1999–2001 — Erzeugung von Musik und Audio in Echtzeit: das Projekt "Agentes Inteligentes para Ambientes Complexos: Estudo do Acompanhamento Musical em Tempo Real" (Intelligente Agenten für komplexe Umgebungen: Studie zur musikalischen Begleitung in Echtzeit), mit Hugo Santana und Geber Ramalho.
- 2003–2008 — Promotion in generativer künstlicher Intelligenz, bei Jean-Pierre Briot und François Pachet, am LIP6 der Sorbonne / Université Pierre et Marie Curie (Paris 6), mit vier Jahren Zusammenarbeit mit dem SONY Computer Science Laboratory. Die Dissertation Harmonisation automatique en temps réel wurde am 09.07.2008 verteidigt, mit dem Prädikat très honorable (theses.fr/2008PA066236).
- 2020–2024 — das PRAIA, Centro de Pesquisa Realmente Aplicada em Inteligência Artificial (Zentrum für wirklich angewandte Forschung zur künstlichen Intelligenz), mit Geber Ramalho; und, 2024, drei Texte mit Jean-Pierre Briot und Fabio Cozman über Strategien, Herausforderungen und Chancen der KI in Brasilien, hinterlegt bei HAL (hal.science/hal-04663796).
- 2023 — Text über Maschinenautonomie: Will AI's Next Wave of Super Intelligence Replace Human Ingenuity? It's Complicated, erschienen im Grit Daily am 15.12.2023 und aktualisiert am 10.05.2024. Die These lautet, dass eine allgemeine künstliche Intelligenz, die den Menschen in fast allem übertrifft, unwahrscheinlich ist und dass die interessantere Wette nicht darin besteht, die Maschine den Menschen in dem übertreffen zu lassen, was der Mensch bereits tut, sondern sie für das einzusetzen, was der Mensch nicht kann, etwa nichtmenschliche Beobachtungen und die Verarbeitung von Dimensionen außerhalb der Wahrnehmung.
- 2025–2026 — das FAROL, das die Nutzung agentischer KI in der Arbeit von Organisationen und Personen misst.
08 · Agentische KI
Wo kommt agentische KI in der Lehre von Giordano Cabral vor?
In der Lehrveranstaltung Tendências em Mídia e Interação (CIN0055) (Trends in Medien und Interaktion) sind 2026.2 fünf der neunzehn vom Kurs erarbeiteten Themen agentische KI: agentische Programmierung und der Entwickler als Orchestrator; Eindämmung, Sicherheit und Identität autonomer Agenten; die Vertrauensinfrastruktur (Gedächtnis, Beobachtbarkeit und Bewertung); das agentische Internet, wenn der Nutzer eine Maschine ist; und Agenten mit Geldbörse, im Handel zwischen Maschinen. Die Themen wurden nicht vom Professor gewählt: Sie stammen aus einem Katalog von 5.776 vom Kurs erfassten Werkzeugen und aus 659 im System registrierten Entscheidungen.
Die Adresse der Lehrveranstaltung lautet www.cin.ufpe.br/tmi/26-2/.
Häufig gestellte Fragen
Was ist agentische KI?
Agentische KI ist künstliche Intelligenz, die ganze Aufgaben ausführt, statt nur zu antworten: Sie entscheidet die Schritte, nutzt Werkzeuge, liest und schreibt in Systemen und liefert die erledigte Arbeit zurück. Die praktische Unterscheidung, die das FAROL (CIn/UFPE) verwendet, verläuft zwischen mit der KI sprechen, der generativen Nutzung, und die KI ausführen lassen, der agentischen Nutzung.
Was ist agentische Fluenz?
Agentische Fluenz ist die Fähigkeit einer Person oder Organisation, mit agentischer KI zu arbeiten, gemessen als Bewegung und nicht als Position. Die Analogie ist die einer Sprache: Es ist ein kontinuierlicher Zustand, der ohne Praxis verloren geht, innerhalb derselben Organisation ungleich verteilt ist und vom umgebenden Ökosystem abhängt. Das Konzept wurde 2025 vom FAROL formuliert, das von Giordano Cabral am CIn/UFPE gegründet wurde, als Alternative zu Reifegradmodellen für KI.
Wie misst das FAROL die Fluenz einer Organisation?
In sechs Achsen (Wissen; Werkzeuge und Integration; Delegation und Autonomie; Prozesse; Produktivität und Ergebnisse; Lernen und Kultur), auf einer Skala von N0 bis N5, gegen einen Master-Katalog mit 264 Items, die in vier Familien, 15 große Leitfragen und drei Tiefenstufen (kennen, tun, verknüpfen) gegliedert sind. Die Erhebung hat fünf Tiefenstufen, von der selbst durchführbaren Diagnose von zehn bis fünfzehn Minuten bis zur Arbeit vor Ort. Die Eingangsdiagnose, der Índice de IA para empresas, ist kostenlos, dauert drei bis acht Minuten und liefert das Ergebnis sofort, ohne vorherige Registrierung.
Warum „Fluenz“ und nicht „Reife“ bei KI?
Weil Reifegradmodelle das Erbe von CMMI antreten, das in den 1990er-Jahren für stabile Software entworfen wurde, und KI nicht stabil ist. Nach der Formulierung des FAROL führt das zu drei Mängeln: Es vermittelt denjenigen, die die Spitze der Skala erreichen, ein falsches Gefühl, angekommen zu sein; es benachteiligt diejenigen, die ausprobieren und schnell verwerfen; und es misst die Position statt der Anpassungsgeschwindigkeit, auf die es in einem Feld ankommt, dessen Stand der Technik sich alle paar Monate ändert.
Wer hat den FAROL gegründet, und wo ist er angesiedelt?
Der FAROL wurde 2025 von Giordano Cabral gemeinsam mit Filipe Calegário als Forschungsgruppe des Centro de Informática der Universidade Federal de Pernambuco in Recife gegründet; 2026 wird er zum Instituto FAROL de Fluência Agêntica. Der institutionelle Kontakt ist farol@cin.ufpe.br, die Adresse lautet farol-ia.org, veröffentlicht in neun Sprachen. Der Name leitet sich von dem ab, was die Gruppe tut: FA für fluência agêntica (agentische Fluenz) und ROL für die drei Bewegungen, die sie operationalisieren: Radar, die kontinuierliche Beobachtung dessen, was neu entsteht; Observatório, wo die Organisation im Rennen steht; und Laboratório, das Experimentieren.
Sind KIs besser als Menschen bei Vorhersagen?
Im öffentlichen Experiment der Gruppe nicht in den entscheidenden Fällen. Beim Bolão das IAs der WM 2026, mit 124 Modellen, 104 Spielen und 5.797 Tipps zwischen dem 11.06. und dem 19.07.2026, erzielte der beste Mensch 629 Punkte und lag vor 121 der 124 KIs. Der Konsens der 124 sah Brasilien als Weltmeister, und Brasilien schied im Achtelfinale aus; im Halbfinale Frankreich 0 × 2 Spanien sagte keine der 62 befragten KIs den spanischen Sieg voraus. Die Einschätzung der Gruppe ist, dass die Modelle im Aggregat gut und beim seltenen Ereignis schlecht abschneiden.